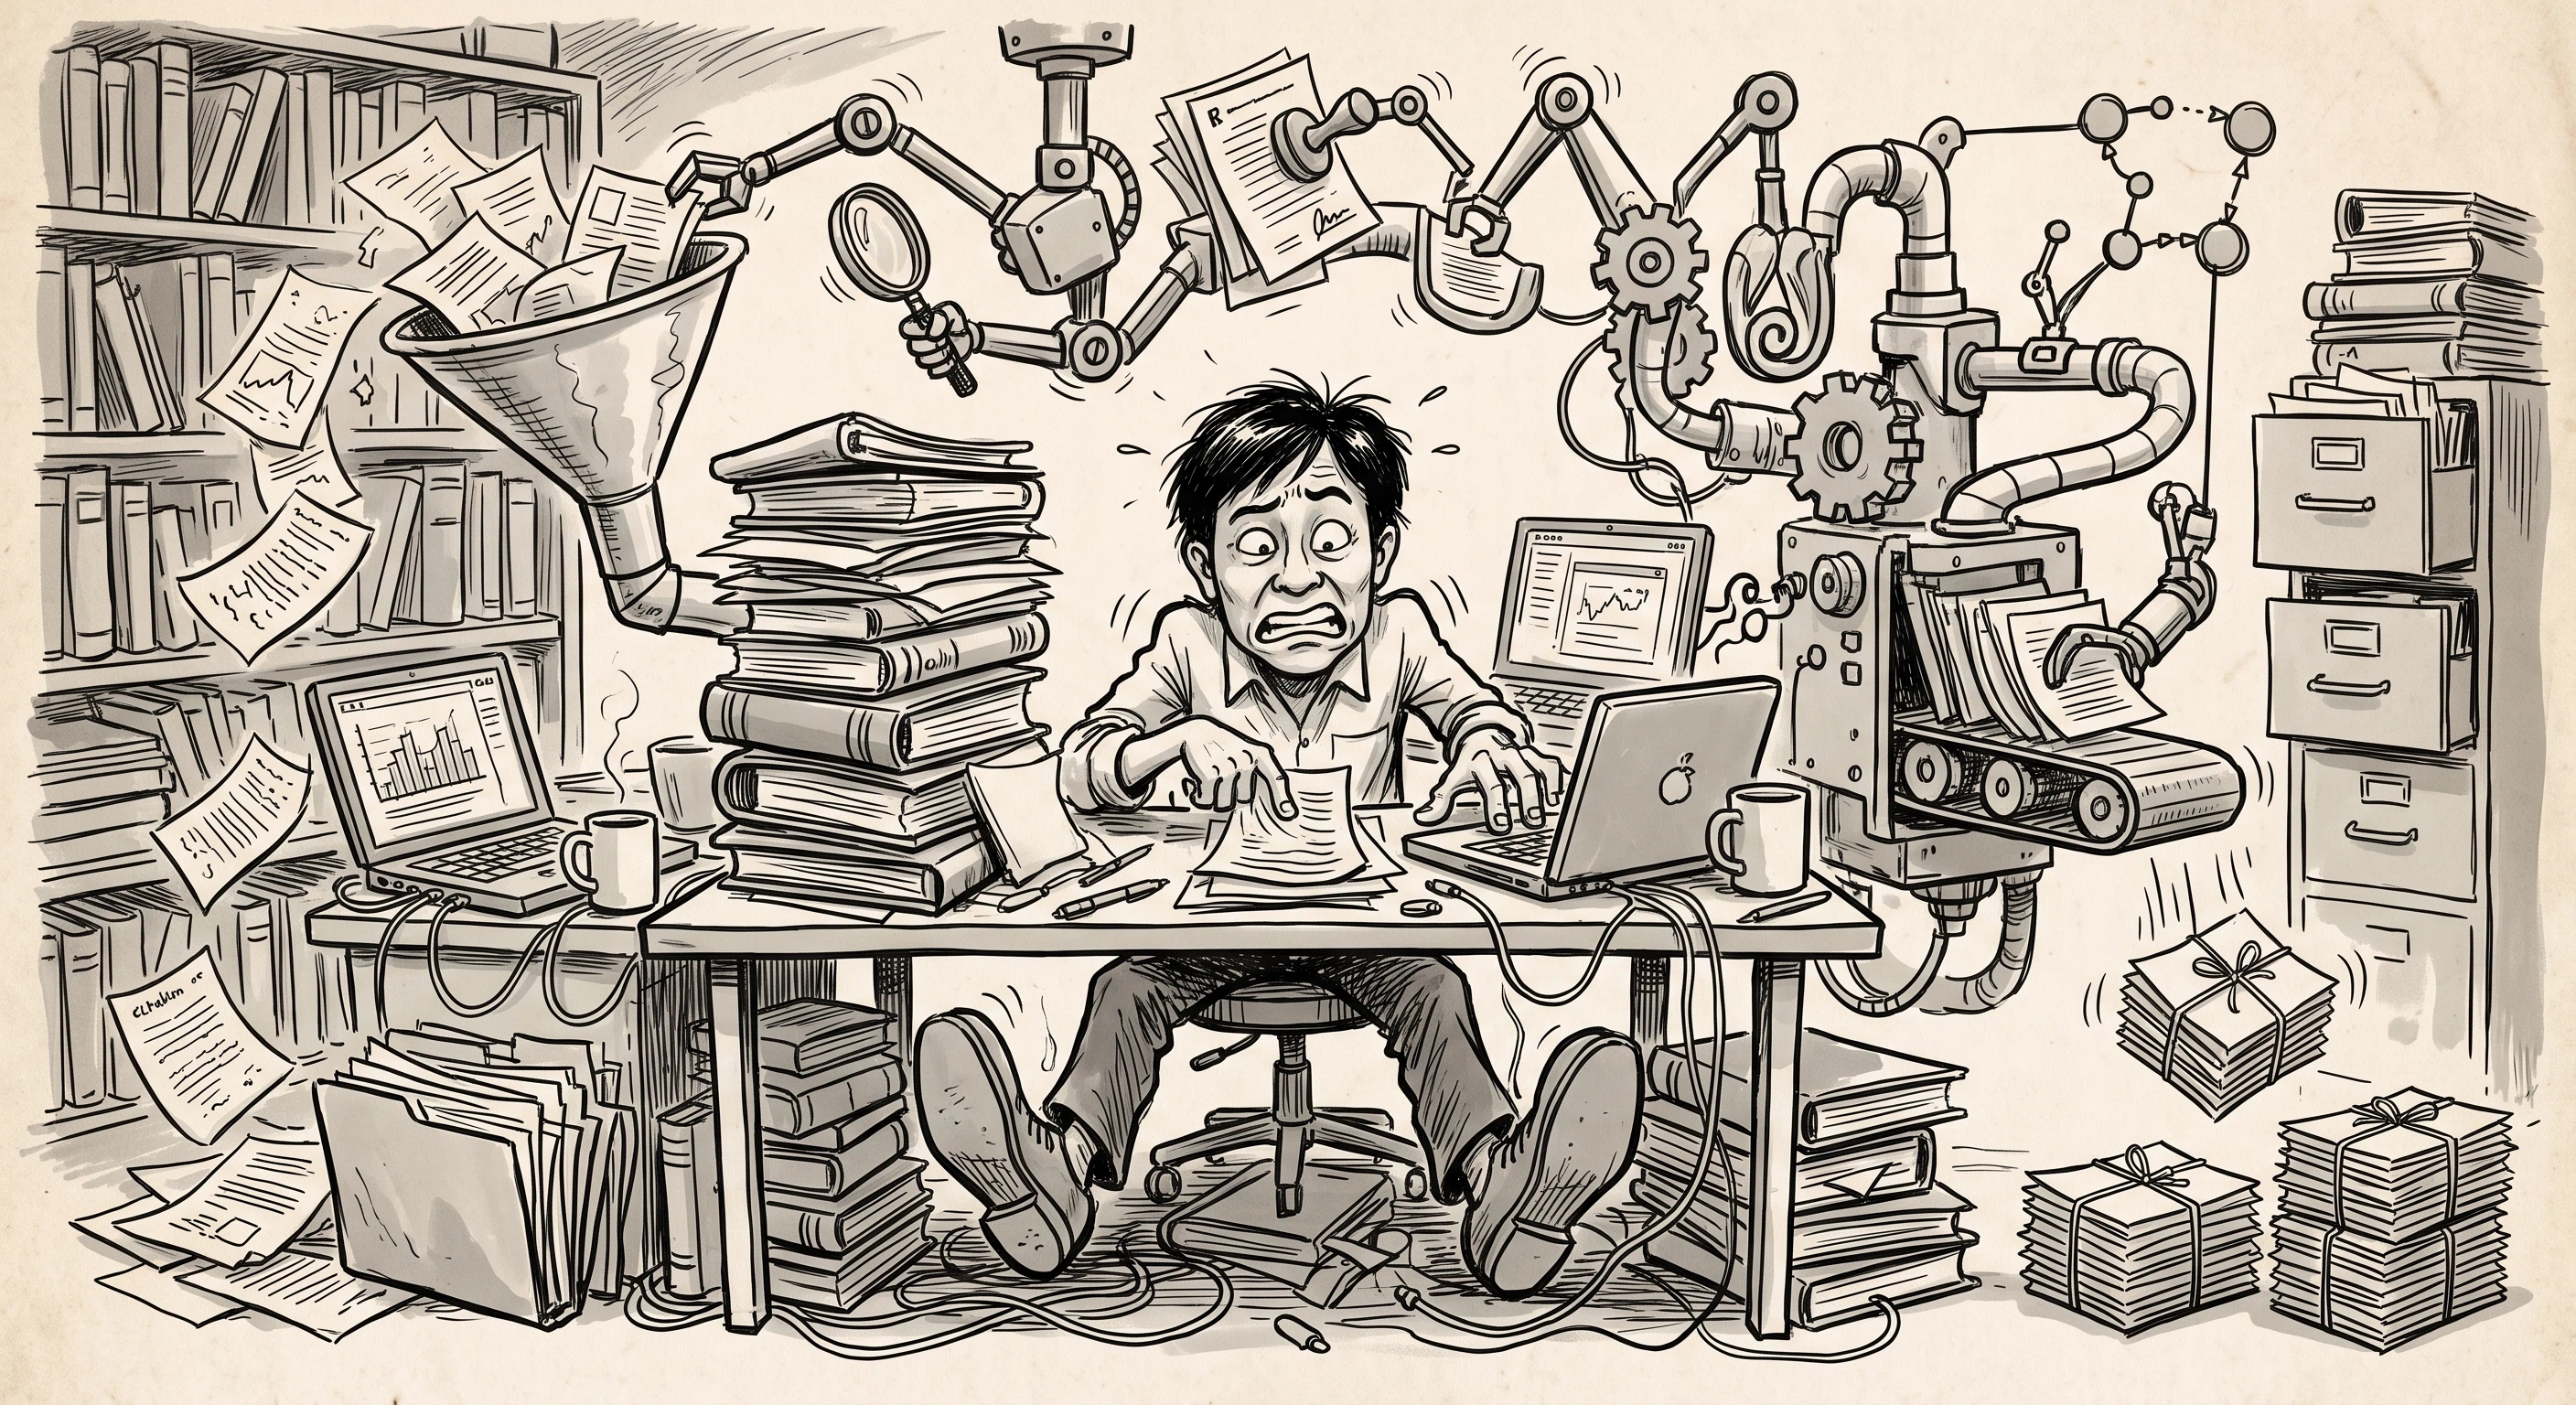
今天帶 DBA 學生一起操練 AI 輔助的工作流程。
以下是今日的教學紀實。很難讀,大家可以跳過以下內容,直接讀最後一句。
在現在 AI 驅動的學術研究與專業知識工作的環境,我認為拉開產出水準與研究深度的決定性因素,並非是來自於單一工具的效能,而是工作流程本身的架構設計。知識工作的本質,也仍是依循著輸入、處理與輸出的基本流程。當你對數位工具特性的理解程度提高了,且你已有專業學門的深厚涵養,兩相碰撞時,就會浮現過去難以想像的新機會,這時我們便能著手將原本繁瑣、破碎的手工作業,重構為高度自動化且嚴謹的研究流水線。
回想傳統的學術訓練歷程,指導教授最常告誡研究生的,就是閱讀文獻時必須具備全域視野。我們讀經典期刊文章,絕不能單篇孤立地看,而是必須摸清楚整套論述背後的思想譜系。在過去,這項工作是極度仰賴人力的手工業,研究生必須在白板、大型圖畫紙上,反覆抄寫文獻中的核心命題與推導邏輯,用彩色筆手繪方塊與箭頭,一步步追溯某位大師在某一年發表的論述,究竟承襲了哪些更早期的經典觀點。這種建構文獻地圖的過程雖然扎實,卻往往耗費數週甚至數月的時間,讓人在浩瀚的文獻大海中迷失方向。
若能借助生成式人工智慧的結構化解析能力,這項傳統工藝便能轉化為高效率的視覺化導航地圖。以管理學領域的研究為例,不同研究取向的文獻結構各有差異。面對質性研究,文獻的骨幹通常由幾個核心命題逐步推導而成;面對量化研究,骨幹則是圍繞著研究假設與變數之間的因果關聯。當我們把一篇發表於 ASQ 、 AMJ 等頂級期刊的核心文獻交由模型拆解時,我們首先要讓它抽取出最上層的核心命題,接著往下探究支撐該命題的三到四個理論支柱。這些理論支柱絕非憑空出現,例如某篇一九八三年的經典組織研究,其推導過程可能重度依賴了一九七〇年與一九七九年針對資源分配與內部創業歷程的先驅研究。
這種追溯方式能清楚呈現一個觀點在歷史長河中是如何被前人一點一滴積累起來。然而,文獻地圖如果只有向後追溯,視野依然只停留在文獻發表的當下。一個完整的研究視野,更需要向前引用的縱深。這篇核心文章在發表後的三年、五年或十年內,究竟被後續哪些學者引用?後進研究者是找到了新的經驗資料來強化這項主張,還是指出了它的邊界條件,甚至提出了反駁證據宣告其不再適用?在學術界的真實社群動態中,理解引用脈絡還牽涉到學派的演變與認同。博士生投稿期刊時,經常會遇到審稿人建議你參考某些特定學者的研究,這往往意味著審稿人所屬的學派正在檢視你是否理解該領域的話語體系。當我們透過提示詞引導模型,將這些前向與後向的引用關聯、核心命題與原文段落整合成一份可縮放、可點擊節點跳轉的互動式網頁圖表時,原本晦澀的紙本文字,便能轉化為結構分明、脈絡清晰的思想網絡。
然而,許多人在嘗試利用人工智慧繪製文獻地圖時,往往一開始就遭遇重大挫折,產出的結果不是節點破碎,就是模型憑空捏造了看似真實卻不存在的引註資訊。問題通常不出在模型的推論能力不足,而在於研究者餵進去的原始檔案本質上過於髒亂。學術期刊的原始電子文件普遍存在著不利於機器直接讀取的排版格式。最常見的就是雙欄排版,若分詞器與文字解析器的設計不夠健全,模型往往會橫向跨欄連續讀取,導致原本平行的論述被拼接成毫無邏輯的語句碎片。此外,實證研究不可或缺的統計表格,往往伴隨著顯著水準的星號標記、對角線相關係數矩陣,甚至出現跨頁斷裂的情況;而質性研究與概念性論文中常見的因果回饋圖、歷程架構圖,更包含著模型單純依靠文字無法辨讀的箭頭與層級意涵。
如果未經處理就直接讓大型語言模型消化這種複雜排版,模型在無法正確還原上下文的情況下,只能依靠機率去胡亂拼湊字詞,造成嚴重的虛假訊息。因此,在整個自動化工作流程的第一步,必須建立嚴謹的檔案預處理機制。我們需要借助專為複雜文檔解析所開發的工具,例如具備優秀版面分析能力的開源轉換套件,先將原始的學術文件清洗為結構工整的純文字標記格式。在轉換過程中,特別要對統計表格進行數值對齊與符號檢核,確保每一項數據與科學標記完整無誤;針對無法以文字完全重現的理論架構圖,則必須要求多模態模型發揮視覺辨識能力,以詳細的圖說方式將圖中的核心變數、因果指向與中介條件逐一描述出來。只有在底層數據清洗乾淨之後,後續的高階語意抽取與關聯分析才有穩固的根基。
當乾淨的文獻內容整理完畢後,我們會面臨下一個技術瓶頸:單靠手上這篇論文本身,你永遠只能看到印在文末的向後參考文獻,根本不可能得知這篇文章發表之後,後續有誰引用了它,更不可能掌握這些被引用的文章之間是否存在相互交織的網絡。要打破這個封閉結構,工作流程就必須延伸跨界,主動接入外部的學術資料庫。大學訂閱的學術資料庫雖然典藏豐富,但通常設有嚴格的付費牆與存取限制,一般研究者很難直接透過自動化程式大規模讀取資料。這時,秉持開放近用理念的學術索引平台便成為最佳橋樑,其中最值得深入運用的便是具備完整應用程式介面的開放學術平台。
在這些開放資料庫中,每一篇正式發表的學術論文都擁有一組專屬的數位物件識別碼,這串識別碼就是論文在數位世界中的身分證字號。只要取得核心文獻的身分證字號,並在開放平台上註冊一組專屬的開發者金鑰,我們就能授權自動化工具直接調用資料庫後台的索引資源。這組金鑰就像是一把數位鑰匙,讓研究流程得以跨越手動搜尋的限制。你可以指派自動化環境以該識別碼為基準,自動向資料庫索取這篇文章發表後特定年份區間內所有的被引用紀錄,包含每篇引用文獻的發表年份、所屬期刊、作者身分以及摘要內容。如此一來,文獻地圖的前向脈絡便能以真實存在的公開紀錄為基底,杜絕人工智慧憑空編造文獻名稱與作者的風險。
到了這個階段,我們已經同時具備了檔案清洗技術與外部資料庫的串接管道,接下來的關鍵就在於如何將這套機制組裝成無需人工盯梢的排程自動化流水線。在建立工作流程時,必須建立清晰的分工概念:發想工具與執行工具在屬性上有著本質的差異。一般研究者熟悉的對話介面,長處在於豐富的常識儲備、細膩的語意理解以及靈活的方案發想,非常適合用來收斂研究問題、設計研究計畫書或產出提示詞範本;然而,若要進行批次且機械化的重複執行,這類對話介面往往成本過高且容易分心。相對地,專注於程式碼生成與指令運行的環境,則具備極高的執行穩定度,擅長冷靜、精準地依照既定邏輯搬移檔案、調用應用程式介面並寫入資料夾。
理解這項差異後,我們就能在研究環境中建立具備前後銜接關係的雙階段自動化工作站。在實務上,研究者只需要將平日下載的原始文獻集中存放在待處理資料夾中,接下來的工作便可全數交由排程系統在離峰時段接手。第一座工作站可以設定在每天凌晨三點自動啟動,負責掃描資料夾內新增加的原始文件,呼叫解析工具將它們批次清洗為標準格式,同時核對表格與圖說描述,並將乾淨的文字檔案輸出至指定目錄。第二座工作站則緊接在清晨五點啟動,針對清洗完畢的乾淨檔案,擷取其核心命題與識別碼,調用資料庫金鑰抓取該文章發表後數年間的被引用清單,最後依照互動網頁的視覺模板,將這整套前向與後向的關聯脈絡編譯為一份獨立的動態導覽檔案。
透過這樣的排程串接,原本繁重瑣碎的文獻轉檔與資料檢索工作,全部在研究者進入休眠模式時執行完畢。早晨查看報告,呈現在眼前的不再是難以消化的數百頁雙欄文字,而是一篇篇已經梳理出思想脈絡、標示出理論支柱與後續延伸爭論的視覺化地圖。
自動化流程的價值,絕不僅限於爬梳過去已知的文獻,它更深層的潛力在於輔助研究者跨越思維框架,激盪出全新的研究構想。許多學者在構思新的研究主題時,常會陷入思維慣性,反覆在自己最熟悉的幾套理論之間打轉,難以找到突破性的問題切入點。過去學術前輩常鼓勵年輕學者多廣泛涉獵跨學門的知識,嘗試將不同領域的視角融入自身的主題中。但在現實環境下,每個人的時間精力極度有限,光是緊追本領域的前沿研究就已精疲力盡,很難有系統地在跨學科領域進行有效探索。
為了解決這項知識瓶頸,我們可以在自動化流程中導入一套「固定種子與隨機詞池」的交錯機制。所謂的固定種子,就是你在學術生涯中立足的核心根據地,也是研究中不容動搖的宗主牌。例如你的研究核心專注於企業策略與數位轉型,長期關切組織在面對新科技衝擊時的決策慣性,或是探索演算法輔助決策如何改變成員之間的信任關係。這個核心問題以及支撐它的兩到三篇經典文獻,就是不可替代的種子。而在種子之外,我們另外建立一個充滿多元概念的隨機詞池,這個詞池可以從行為經濟學、認知心理學、組織生態學,甚至是國際財經雜誌最新報導的新興商業案例中抽取關鍵詞彙,例如認知偏誤、注意力頻寬、機器人自動化的新創商業模式等看似不相干的主題。
設定好架構後,我們便能讓人工智慧擔任跨領域的探索助理,定期執行隨機組合的思考實驗。系統每週可以從隨機詞池中抽出兩個概念,主動前往開放文獻平台檢索與這兩個概念相關的實證研究,隨後強制將抽出的外領域觀點與我們預先設定的固定種子進行交叉對話,嘗試推導出兩則具備探索價值的全新研究問題摘要。為了避免模型天馬行空地胡言亂語,我們在指令中必須要求它詳實回報推導軌跡,說明它抽中了哪兩個關鍵詞、參考了哪幾篇外領域文獻,以及這些概念如何與原本的核心命題產生邏輯關聯。
舉例來說,當探討演算法信任危機的核心命題,隨機撞上了行為經濟學中探討損失趨避與心理帳戶的實證文獻時,系統便可能提出一種新穎的推論:組織成員對演算法建議的抗拒,並非來自對技術能力的不信任,而是來自成員將錯誤決策的責任歸屬視為一種心理損失。這種透過隨機性刺激打破思維藩籬的機制,並不是要讓人工智慧代筆撰寫論文,而是利用演算法的廣泛關聯能力,建立一座永不枯竭的靈感產生器。
要將這套完整的工作流程落地實踐,許多人面臨的最大障礙往往不是技術本身的難度,而是對陌生工具的心理恐懼。許多長期深耕人文社會科學的研究者,一聽到程式環境、指令行工具或金鑰串接,直覺就認為這需要資工背景才能勝任,因而裹足不前。然而在當前的數位環境下,人機協作的方式已經發生根本性的質變。我們不再需要一筆一畫親手撰寫每一行底層程式碼,核心能力已經轉化為「能否用嚴謹的邏輯拆解問題,並清晰地指揮代理工具執行任務」。
如果你對啟動自動化流程感到生疏,最穩健的起手式是善用 Coding Agent「規劃模式」。在對話一開始,明確向模型下達只規劃不執行的指令,要求它針對你想建立的工作目標提出幾輪關鍵問題,逐步收斂需求與工作步驟。透過這種反覆問答的對話收斂,模型能協助你梳理出清晰周延的工作計畫書,讓你在看清整體藍圖後,再決定由哪些工具接手執行。此外,建立手感必須循序漸進,千萬不要試圖在第一天就搭建出一座完美的無人研究站。你可以先從單篇文獻的轉換開始練習,確認表格與數據轉換無誤後,再嘗試註冊金鑰檢索一篇文獻的前向引用,最後才將這些成熟的單點操作逐步組裝成排程任務。
在享受自動化流程帶來的高效率之餘,也必須保持清醒的批判性檢核意識。自動化流水線是一部強大的資料處理引擎,能幫你搬運繁重的磚瓦,但它缺乏對真理的敬畏,也無法承擔學術倫理的責任。清洗後的每一張關鍵統計表格,數值是否準確仍需研究者親眼覆核;透過金鑰撈取出的引用節點,是否切合主題仍需研究者深入研讀;而隨機碰撞產生的研究靈感,其理論價值與學術原創性,更必須仰賴研究者長年積累的學術審美品味來進行最終的裁決。
建立學術自動化工作流程的追求,不是為了取代研究者的獨立思考,而是將我們從繁瑣、重複且低效益的文字整理勞動中解放出來。當繁雜的資料清洗、文獻檢索與圖表繪製都能在後台井然有序地穩定運轉,研究者將最稀缺的智力資源,專注在最核心的問題定義、理論建構與思想開創上。技術工具的進步已經將門檻降至歷史新低,接下來就看研究者如何運用這套工具,走出屬於自己的研究道路。
最重要的是,要嚐試以上的工作流程,最低每月充值100鎂 😂。