當 AI 用你說過的話佈置一間房:從「填滿空房間」迷因,看我們如何在演算法鏡子裡找自己
打開社群軟體,你可能已經在動態牆上看過無數間這樣的房間。
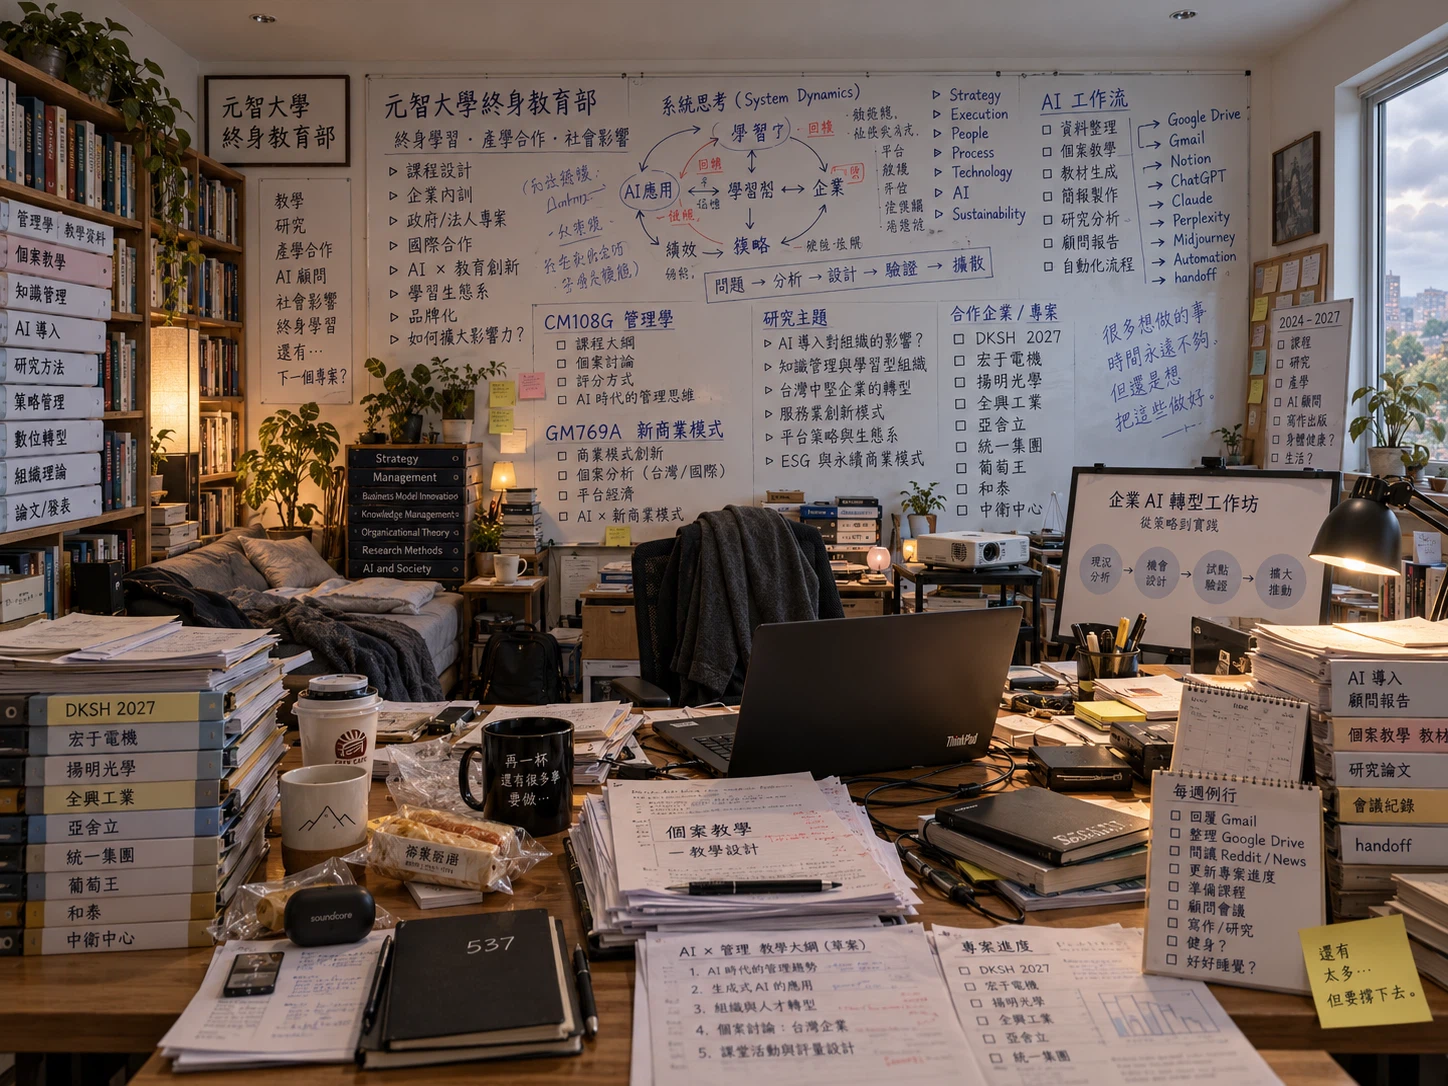
畫面裡沒有半個人影。陽光從落地的玻璃窗灑進來,照在一張略顯凌亂的木頭書桌上。桌上擺著三台螢幕,正中央的畫面停留在寫了一半的企劃案,旁邊放著喝了一半的冰美式咖啡與吃剩的喉糖;牆上釘滿了密密麻麻的便利貼與紅線交錯的進度表;角落的貓跳台上窩著一隻橘貓,旁邊的矮櫃堆著還沒拆封的桌遊、幾本翻舊的心理學著作,地板上還散落著一雙跑鞋與剛卸下的重訓腰帶。
貼文的文字欄往往只有短短一句話:「跟風玩了一下,叫 ChatGPT 用它對我的所有了解填滿這個房間,結果準到有點毛骨悚然。」底下的留言區更是熱鬧。熟識的朋友會像玩「威力在哪裡」一樣,在畫面角落尋找自己熟悉的線索:「那個第三個螢幕根本就是你每天加班的樣子」、「角落那疊沒看完的書太寫實了吧」;也有人會無情吐槽:「為什麼你的房間看起來像剛被闖空門?」或是像 Dcard 討論板上的熱門貼文一樣,原本發文者滿心歡喜地把這間擺滿佛像、經書、花草與茶具的空間稱為「陽光禪意花園書房」,留言區的網友卻一針見血地笑稱「這佈置根本像告別式現場」。
這股在 2026 年秋天席捲全球社群平台的「填滿空房間」(Fill this room with everything you know about me)風潮,表面上看起來只是一場無傷大雅的 AI 室內設計遊戲。使用者丟出一張空白房間的底圖,或者只輸入一行簡單的提示詞(Prompt):「用你對我的所有了解填滿這個房間,不要出現任何真人圖片,誇張一點。」幾十秒後,生成式 AI 就會調動過去幾個月甚至幾年來的對話紀錄與系統記憶,把一個人散落在聊天視窗裡的喜怒哀樂、工作焦慮、飲食癖好與深夜呢喃,全部轉譯成具體的家具、擺設與雜物。
但如果我們把鏡頭拉遠,把這股熱潮放進心理學與人機互動(HCI)的脈絡裡仔細端詳,會發現事情遠比「AI 畫圖好不好看」深刻得多。
這其實是人類數位生活史上一個非常奇妙的轉折點:我們第一次主動要求一個非人類的演算法系統,把它在背景裡默默建構的「使用者模型」(User Model),轉譯成一張看得見、摸得著(至少在視覺上)、可以公開展示並讓朋友品頭論足的自我肖像。
正如 Reddit 論壇上那篇整理了 30 種個人化圖像提示詞的熱門長文原作者所說的,這整場遊戲最核心的動機其實只有一句話:「你跟我聊了這麼久,現在,讓我看看你建構出來的我是誰。」
為什麼我們會如此渴望知道「AI 眼中的自己」長什麼樣子?當畫面裡沒有我們的臉孔與身材,只剩下被物化的書本、工具、盆栽與錯誤視窗時,為什麼我們反而覺得「這比自拍照更像我」?而當我們看著這面由演算法打磨出來的鏡子,一邊驚嘆它懂我、一邊把圖片貼上社群等待按讚時,這面鏡子會不會正在不知不覺間,反過來重塑我們對自己的認知,甚至讓我們一步步交出更多原本不打算公開的隱私?
這篇文章想帶你拆解的,正是這間「AI 房間」背後的心理學暗流、視覺語法與隱私邊界。我們不談艱澀難懂的數學公式,而是從你我每天滑手機、跟 AI 聊天的日常經驗出發,看看當生成式 AI 成為一面會畫畫的魔鏡時,人是如何透過它來重新認識自己。
為什麼我們開始請 AI 畫出「沒有臉的自畫像」?
在過去十幾年的社群媒體時代,人們表達「我是誰」最直接的工具是自拍(Selfie)。無論是在咖啡廳打卡、在健身房對著鏡子拍照,還是挑一張套了柔和濾鏡的旅遊照當大頭貼,傳統的數位自我呈現高度依賴「臉孔、身體與當下的真實場景」。
然而,自拍有一個先天的心理負擔:它太容易觸發外貌焦慮與社會比較,而且一張照片只能捕捉某一個瞬間的表象。你可能今天穿得很體面去參加婚禮,但那張照片並不能說明你過去三個月都在為一個跨國專案失眠,也看不出你私底下是個迷戀冷門歷史與手沖咖啡的完美主義者。
「用你對我的了解填滿房間」這類提示詞之所以能瞬間引爆,正是因為它提供了一種截然不同的自我表達方式——在學術與設計研究上,我們可以稱之為 「演算法自我肖像」(Algorithmic Self-Portrait),或者更直白地說,是一種 「物件化自我肖像」。
在這種肖像裡,「不出現真人圖片」原本只是網友為了避免 AI 畫出恐怖谷效應的怪異人臉、或是為了保護長相隱私而加上的限制條件;但這個限制卻意外打開了一個更迷人的心理空間。當畫面裡不能有「人」的時候,AI 就必須像一位劇場佈景師或人類學家一樣,用「物」來代替人說話。
在心理學與物質文化研究中,人類本來就會透過自己擁有的物品與身處的空間來延伸自我。你的書架上擺什麼書、桌面上開著哪些視窗、角落堆著什麼沒做完的手作材料,往往比你的證件照更能誠實地反映你的內在秩序與混亂。而現在,幫你挑選這些代表物的不是你自己,而是那個陪你改過履歷、聽你抱怨過主管、幫你查過深夜胃痛原因、跟你一起腦力激盪過無數鬼點子的 AI。
這個概念在近年的人機互動研究中早有跡象。2022 年,史丹佛大學與密西根大學的研究者 Angela Y. Lee、Hannah Mieczkowski、Nicole B. Ellison 與 Jeffrey T. Hancock 發表了著名的「演算法水晶」(Algorithmic Crystal)研究。他們訪談了許多 TikTok 使用者後發現,人們並不是被動地接受演算法推播的影片,而是把個人化演算法當成一顆多面折射的水晶:當我們滑著「為你推薦」(For You Page)時,我們其實是在透過「演算法認為我喜歡看什麼」,來拼湊、折射並理解自己是個什麼樣的人。
到了 2026 年 6 月,韓國蔚山科學技術院(UNIST)的研究團隊 Yeowon Lee、Youngseo Kim 等人在 ACM 設計互動系統研討會(DIS 2026)發表的論文〈Is This the Real Me?〉,更直接把「演算法自我肖像」(Algorithmic Self-Portraits)當成研究工具,讓使用者觀看由自己的 YouTube 觀看紀錄所生成的視覺化肖像,藉此激發人們去反思「我心目中的自己」與「演算法系統眼中的我」之間到底有哪些落差。
有趣的是,原本在學術實驗室裡需要研究人員特別設計軟體才能引導出來的反思,到了 2026 年秋天,竟然變成全球網友自發參與的民間大型實驗。過去我們只能從抖音推給我們的短影音、Spotify 每年底的年度回顧歌單,去旁敲側擊演算法給我們貼了什麼標籤;現在,生成式 AI 的多模態能力把那層黑盒子直接掀開了一角——你只要打一行字,它就能把對你的印象畫成一幅高解析度的插畫。
一場迷因的誕生:從 Reddit 的三十種腦洞到跨海洗版的空房間
如果我們像做田野調查一樣,回頭去梳理這波「填滿房間」浪潮的傳播軌跡,會發現它並不是某一天突然從石頭裡蹦出來的單一創意,而是 「早就存在於玩家圈的 AI 個人化自畫像文化」,剛好撞上了 「空房間這個極度直觀、極容易複製的視覺容器」,兩者擦出火花後才在 2026 年 9 月底至 10 月引爆全球。
為了不被網路上的二手傳言誤導,我們必須把公開可查證的時間線拆成「廣義的個人化自畫像玩法」與「狹義的空房間迷因」兩條線索來看。
早在 2026 年初至夏末,英語社群的 AI 玩家就已經非常熱衷於測試 ChatGPT 的記憶功能(Memory)。例如在 Reddit 的 r/ChatGPT 板上,2026 年 1 月與 2 月就陸續有熱門討論串請大家輸入「根據你對我的了解,畫出一張代表我的圖像或物品」。到了 2026 年 8 月底,一位 Reddit 使用者發表了一篇極具代表性的長文,一口氣整理出 30 種「讓 ChatGPT 用它已知的一切來畫我」的提示詞模板。
那位原作者分享的心路歷程非常關鍵:她說自己一開始只是好奇,如果不給 AI 任何外貌描述、不告訴它自己喜歡什麼顏色或風格,純粹強迫它調用過去的對話與記憶(use everything it already knows about me from our conversations and memory),AI 會變出什麼把戲?結果她一試成主顧,一口氣開發出「我的腦內世界」、「個人作業系統」、「RPG 技能樹」、「個人博物館」、「奇珍收藏櫃」、「人生冰山圖」、「五分鐘任務失控流程圖」、「個人元素週期表」、「人生主題樂園」與「終極自我海報」等 30 種變體。
這篇貼文證明了一件事:在「空房間」爆紅之前,利用生成式 AI 的長期記憶來做視覺化自我探索的玩法,已經在重度使用者之間相當成熟。但為什麼這 30 種玩法沒有每一個都變成全民運動,偏偏是後來簡化版的「空房間」成了現象級迷因?
關鍵的轉折點出現在 2026 年 9 月 27 日。根據比利時獨立科技觀察網站 AI Op Zak 於 2026 年 10 月 17 日發布的趨勢考據報告以及搜尋引擎留存的索引紀錄,知名 AI 創作者 Kris Kashtanova(X 帳號 @icreatelife)在 9 月 27 日貼出了一張空蕩蕩的房間圖片,邀請網友把這張圖丟進 ChatGPT,並輸入:「Knowing everything you know about me, fill this room.」(根據你對我的所有了解,填滿這個房間。)
更值得注意的是,就在同一天,Kashtanova 又迅速發出了一個修正補充版:「Knowing everything you know about me fill this room. Except deeply personal info.」(填滿這個房間,但排除深度個人隱私資訊。)這個在傳播第一天就出現的微小補丁,透露出一個極為重要的訊號:人們在享受「被 AI 看穿」的快感時,幾乎是同步意識到了「它可能會把我不該公開的祕密畫出來」的赤裸感。
與此同時,搜尋紀錄中也留存著 9 月 28 日有 X 平台使用者感嘆「The blank room is trending again」(空白房間又開始流行了)。這句話提醒我們保持研究者的謹慎:即便 9 月 27 日是 2026 年秋季這波浪潮最清晰的擴散起點,但「把空白房間拿來填滿」的視覺互動概念,在網路社群裡很可能早有前身,不應輕易把單一貼文神話為絕對的「唯一發明者」。
進入 10 月之後,這股風潮開始跨平台大遷徙。10 月上旬,Instagram 與 Threads 上開始大量出現英文版教學,教大家「把這張空房圖存下來丟給 ChatGPT」;到了 10 月 11 日至 13 日前後,Facebook、Instagram 與 X 迎來了第二波集中爆發,許多創作者不僅貼出生成的房間,還會在貼文裡附上空白底圖,形成「一傳十、十傳百」的接力蓋樓效應。甚至連 TikTok 都成了重要的擴散跳板,許多 Threads 使用者在貼文中坦言自己是先在 TikTok 刷到「empty room ChatGPT trend」才跑來跟風。
緊接著在 10 月中下旬,這股浪潮正式席捲繁體中文世界。在臺灣的 Threads、Facebook 與 Dcard ChatGPT 板上,英文提示詞被在地化並演化出一套高度固定的中文咒語:
「用你對我的所有了解填滿這個房間,不要出現任何真人圖片,誇張一點。」
仔細品味這句繁體中文社群共同演化出來的版本,會發現臺灣網友非常有才華地在短短二十幾個字裡,塞進了三個不同層次的心理需求:
- 「用你對我的所有了解填滿這個房間」:要求 AI 展現個人化記憶與理解深度。
- 「不要出現任何真人圖片」:築起第一道外貌隱私防線,同時避開 AI 畫人臉的不自然感,強迫畫面聚焦在象徵物上。
- 「誇張一點」:這是最神來一筆的在地化增補(英文圈也有類似的
but make it exaggerated變體,如 Free Republic 論壇上的討論)。加上「誇張一點」,一方面能增加畫面的戲劇張力與喜劇效果(比如喜歡喝咖啡的人,房間裡直接出現一座咖啡豆山或十台義式咖啡機),另一方面也在心理上替自己留了台階——如果 AI 畫出什麼荒謬或尷尬的東西,我可以笑著說「因為我叫它畫誇張一點啦」,瞬間化解被看穿的尷尬。
為了讓大家更清楚看懂這波跨平台演化的脈絡,我們可以把目前查證到的關鍵節點整理成一張演化時間表:
| 時間節點 | 關鍵事件與社群現象 | 心理與傳播意義解讀 | 資料核對狀態 |
|---|---|---|---|
| 2026 年 1–8 月 | Reddit r/ChatGPT 社群陸續出現「用 AI 已知的一切畫我」討論,8 月底出現完整的 30 種個人化圖像提示詞大全 | 廣義的「演算法自畫像」文化已經成形,重度玩家開始探索如何把 AI 記憶轉為視覺符號 | Reddit 原帖與早期討論串可直接檢視驗證 |
| 2026 年 9 月 27 日 | Kris Kashtanova (@icreatelife) 在 X 發布空房間底圖與「fill this room」提示詞 |
將複雜的自我探索壓縮成極簡、低門檻、極易複製的「填空」視覺模板,成為本輪迷因主起點 | 搜尋索引與 AI Op Zak 報告交叉驗證(X 原頁受存取限制) |
| 2026 年 9 月 27 日 | 同日補充「Except deeply personal info」(排除深度個人資訊)版本 | 證明隱私焦慮並非事後學者的過度解讀,而是在迷因誕生第一天就被創作者與玩家敏銳察覺 | 搜尋索引與 Instagram 衍生貼文可交叉核對 |
| 2026 年 9 月 28 日 | X 平台有使用者提到「The blank room is trending again」 | 顯示空房間填圖概念可能有更早期的網路前史,分析時應視為「本波擴散起點」而非絕對首創 | 公開搜尋索引紀錄可查 |
| 2026 年 10 月上旬 | Instagram 與 Threads 湧現大量英語跟風貼文與教學 | 從單一創作者的實驗,正式轉變為一般大眾都能複製貼上的社群互動模板 | Instagram 公開貼文與搜尋索引可核對 |
| 2026 年 10 月 11–13 日 | 歐美社群迎來第二波高峰,「附空白底圖+蓋樓曬圖」成為標準玩法 | 形成強烈的社群比較與尋寶效應,觀眾在留言區替彼此「解讀房間」成為核心樂趣 | Facebook 貼文與 AI Op Zak 報告可確認 |
| 2026 年 10 月中下旬 | 繁體中文社群(Threads、FB、Dcard)爆發,定型為「不要真人+誇張一點」 | 在地化過程中同時加入了外貌防禦機制(「不要真人」)與喜劇緩衝機制(「誇張一點」) | Dcard 實例與 Free Republic 討論可驗證 |
為什麼在那麼多種玩法裡,偏偏是「空房間」贏得了這場注意力大戰?
答案藏在它的媒介結構裡。首先,它的參與門檻低到不能再低:你不需要懂任何繪圖術語(什麼光影、構圖、鏡頭焦距通通不用管),也不用上傳自己的真實照片,只要複製一句話就能玩。其次,「房間」是所有人類最熟悉的空間隱喻——每個人都有房間,每個人都知道書桌、床鋪、牆壁和地板代表什麼。當十個朋友同時貼出自己的 AI 房間時,大家是在同一個框架下比對細節:你的房間是冷色調的極簡實驗室,他的房間是堆滿貓罐頭與吉他效果器的溫暖閣樓。這種 「框架一致、細節萬千」 的特性,讓它同時滿足了「跟上流行」的歸屬感,以及「展現我是獨一無二」的獨特性需求,更在畫面裡留了無數個小彩蛋,邀請朋友留言互動。
容器決定了你是誰:十四種「演算法自我肖像」的視覺語法
雖然「空房間」最紅,但如果我們只看房間,就會錯過這波現象最迷人的深層規律。
當我們回頭去讀 Reddit 上那份包含 30 種個人化圖像提示詞的清單時,會發現一個連許多使用者自己都沒意識到的心理學現象:你選擇用什麼「容器」來裝自己,決定了 AI 會如何定義你的「人格」。
這就像你請一位畫家幫你畫像,如果你請他畫「我的書房」,他一定會去觀察你讀什麼書、用什麼文具;但如果你請他畫「我的大腦內部工廠」,他就會開始畫你的焦慮、你的拖延症跟你的白日夢。在生成式 AI 的世界裡,提示詞裡的空間或系統隱喻,本身就是一個強大的篩選器(Filter)——它預先決定了你過去對話紀錄裡的哪些碎片會被放大,哪些碎片會被忽略。
為了看清這套「視覺語法」是如何運作的,我們以「不出現真人臉孔」為前提,從 Reddit 的 30 種原型與社群變體中,挑選出最具代表性的 14 種「演算法自我肖像」類型。你可以邊看邊想像,如果把同一個人的聊天紀錄丟進這 14 個不同的容器裡,長出來的「自我」會有什麼天壤之別(表中的隱私風險等級,是根據畫面可能夾帶的可識別文字、資訊密度、是否容易波及身邊親友與可反推程度所做的綜合評估):
| 肖像類型 | 提示詞核心概念(Prompt 短例) | 視覺呈現模態 | 隱私暴露風險 | 畫面常見的符號與輸出細節 | 背後的社交與心理意圖 |
|---|---|---|---|---|---|
| 1. 空房間 (Empty Room) |
用你已知關於我的一切填滿這間空房;不要出現人物 | 室內空間透視、物件陳設敘事 | 中 | 書堆、工作桌、多螢幕、興趣收藏、植物、寵物用品、未完手稿 | 自我反思/生活品味展示 |
| 2. 腦內世界剖面圖 (Dollhouse / Inside My Head) |
把我的人格與生活做成娃娃屋剖面圖,每個房間代表一部分的我 | 建築剖面圖、多隔間隱喻空間 | 中高 | 「焦慮控制室」、「深夜點子實驗室」、「拖延症倉庫」等分區 | 深層自我剖析/自嘲(Roast) |
| 3. 個人博物館 (Personal Museum) |
建造一座完全關於我的博物館,包含常設展廳與鎮館之寶 | 展覽館空間、玻璃展櫃與策展說明牌 | 高 | 人生里程碑、重要專案成果、關係紀念物、特定年份的回憶展品 | 成就展示/人生階段回顧 |
| 4. 奇珍收藏櫃 (Cabinet of Curiosities) |
用一個多格木櫃裝滿象徵我歷史、習慣與怪癖的奇珍異寶 | 復古靜物架、高密度微型象徵物 | 中 | 罕見小工具、奇怪的紀念品、只有自己懂的符號、舊票根與收藏 | 展現獨特怪癖/文青式展示 |
| 5. 個人作業系統 (Personal OS) |
把我設計成一套電腦作業系統桌面,顯示我常駐的背景程式与錯誤視窗 | 電腦圖形介面(GUI)、視窗與資訊架構 | 高 | 特定資料夾名稱、17 個未讀通知、背景執行的 Overthinking.exe |
剖析思考習慣/高密度自曝 |
| 6. 新手村標準配備 (Starter Pack) |
用最能代表我日常形象的 6 到 8 樣物品做成新手包圖卡 | 去背物件拼貼、雜誌商品圖錄風 | 中高 | 常喝的飲料品牌、特定型號耳機、穿搭單品、口頭禪字卡、隨身工具 | 快速社交破冰/幽默自嘲 |
| 7. RPG 技能樹 (RPG Skill Tree) |
把我的能力、習慣、弱點與支線任務做成遊戲技能樹 | 暗黑奇幻或科幻風遊戲介面資訊圖 | 中 | 核心主修技能、增益效果(Buff)、睡眠不足減益(Debuff)、支線任務 | 盤點能力優勢/遊戲化自我檢視 |
| 8. 人生處女作徽章 (Achievement Badges) |
將我真實的專業成就與荒謬的生活怪癖設計成解鎖徽章 | 向量圖標卡、遊戲成就解鎖清單 | 中 | 「凌晨三點改稿王」、「買書不看大師」、特定專業領域破關獎章 | 幽默展示怪癖/尋求同溫層共鳴 |
| 9. 個人冰山圖 (Personal Iceberg) |
從大家都知道的表象,到最深層的個人背景故事(Lore)分層繪製 | 海平面上下分層資訊圖、文字搭配插畫 | 高 | 水面上:職業與公開嗜好;深海層:童年陰影、私密怪癖、反覆糾結的議題 | 深度自我揭露/測試誰最懂我 |
| 10. 偵探推理線索板 (Conspiracy Board) |
把我常思考的主題與執念做成貼滿照片與紅線的偵探推理板 | 軟木塞板、紅線網絡圖、便利貼與剪報 | 高 | 正在研究的專案關鍵字、人際關係連結、滿滿的問號便條、書頁截圖 | 展現思維狂熱/自嘲鑽牛角尖 |
| 11. 五分鐘任務失控圖 (5-Minute Task Flowchart) |
畫出當我打算「只花五分鐘做件事」最後卻徹底失控的流程圖 | 幽默漫畫分鏡、箭頭流程圖 | 低至中 | 從「整理桌面」一路分心到「查維基百科三小時」、「重寫整套分類系統」 | 高度共鳴的自嘲/檢視行為模式 |
| 12. 個人元素週期表 (Periodic Table of Me) |
把構成我生命的重要事物變成化學元素符號並分類排列 | 科學圖表、色塊分類矩陣 | 中高 | 以縮寫代表特定親友、常去城市、核心習慣、專業技能與長期困擾 | 結構化自我盤點/知性展示 |
| 13. 人生主題樂園 (Personal Theme Park) |
把我的生活、恐懼與熱愛變成一座主題樂園的導覽地圖 | 鳥瞰插畫地圖、遊樂設施與警告標語 | 中高 | 「截稿日雲霄飛車」、「咖啡因補給站」、「社交恐懼鬼屋」、專屬紀念品店 | 戲劇化轉譯人生/創意社交分享 |
| 14. 終極自我海報 (Ultimate Me Poster) |
用數十個具體彩蛋濃縮你所知道的我,做成高密度插畫海報 | 極繁主義(Maximalism)電影海報拼貼 | 極高 | 工作細節、人際關係、過往對話梗、飲食偏好、挫折與夢想全部混搭 | 終極尋寶遊戲/全方位自我展演 |
看著這張表,你會發現一件非常奇妙的事:同樣是一個人,換一個提示詞容器,AI 就會幫你切出完全不同的人生剖面。
為了讓這個概念更具體,我們不妨直接在腦海中打開三個不含真人的視覺模擬畫面(Mockups),看看當同一個「每天跟 AI 討論工作的台灣知識工作者」輸入不同指令時,畫面其實是在回答什麼問題:
| 視覺容器模擬 | 畫面裡會出現什麼具體細節? | 這個容器本質上是在替你問什麼問題? |
|---|---|---|
| 模擬一:空房間 (空間與物質隱喻) |
一張大工作桌、三疊貼滿標籤的書、三個螢幕、一面畫滿流程圖的白板牆、角落堆著還沒組裝的模型與半箱氣泡水。 | 「如果把我的生活全部變成實體物品,什麼東西最佔據我的空間與注意力?」 |
| 模擬二:個人作業系統 (心智與運作隱喻) |
桌面上有 Projects_Final_v3/、深夜胡思亂想/、待回訊息/ 資料夾;右上角跳出 17 個未讀通知;工作管理員顯示 Overthinking.exe 佔用了 85% 記憶體。 |
「我的大腦平常是怎麼運轉的?哪些焦慮或任務一直在我的背景程式裡偷偷耗電?」 |
| 模擬三:個人冰山圖 (表裡與深度隱喻) |
水面上是「行銷企劃、手沖咖啡、慢跑」;水面下第一層是「完美主義、資訊焦慮」;最深的海底寫著某個跟 AI 聊過三次卻從沒跟朋友提過的轉職念頭。 | 「在 AI 眼裡,哪些關於我的事只是給別人看的表面,哪些才是我藏在水面下的祕密?」 |
這就是「容器決定論」最耐人尋味的地方。
當你選了**「空房間」,你是在用「我擁有什麼、我待在什麼環境」來定義自己,這是一種偏重生活風格與日常物質的自我呈現;當你選了「RPG 技能樹」,你瞬間把人生變成一場打怪升級的遊戲,強迫 AI 用「能力值、優勢、弱點、待解任務」的功利框架來評估你;當你選了「五分鐘任務失控流程圖」,你看的不再是靜態的物品,而是你這個人「一遇到事情會怎麼分心、怎麼鑽牛角尖」的動態行為模式;而當你選了「個人博物館」**,你則是把自己當成歷史人物,請 AI 為你過去幾年的成敗得失寫下策展論述。
換句話說,不是 AI 單方面決定了你是誰,而是你挑選的提示詞隱喻,先替 AI 戴上了一副特定顏色的眼鏡。
而在這無數張被貼上網的房間、作業系統與冰山圖底下,世界各地網友看完圖後的反應,幾乎都可以歸納成四種非常鮮明的心理劇場:
第一齣戲:「天啊,它居然連這個都記得!」(被理解的驚喜與獎賞)
這是支撐整場迷因不斷擴散的最大動力。正如 AI Op Zak 的趨勢觀察所指出的,大多數參與者最初的反應都是驚呼「太準了吧!」。你半年前隨口問過一次怎麼種龜背芋,今天房間角落就擺了一盆生機盎然的龜背芋;你上個月為了某個冷門程式語言抓狂了三天,牆上就出現了那個語言的吉祥物海報。
在人類的人際關係裡,「不用我特別提醒,你卻記得我隨口說過的小事」是一種極高濃度的情感獎賞——那代表你在乎我、你有把我的話放在心上。儘管我們理智上百分之百清楚 ChatGPT 只是一套透過資料庫檢索與機率先驗來運作的軟體,但當它把散落在幾十次對話裡的微不足道小事,精準地組合成一個溫馨的角落時,我們的大腦依然會瞬間分泌出「被深深理解、被看見」的愉悅感。
第二齣戲:「等等,它知道得太多了……」(滯後的隱私驚醒)
然而,驚喜往往維持不到五秒鐘,就會被另一種情緒取代:背脊發涼的「被監看感」(Creepiness)。
在 Reddit 的 30 種提示詞討論串裡,就有網友留言坦言:自己照著指令跑出了圖片,結果畫面裡出現了太多極度私密的個人細節,讓他當下決定「這張圖絕對不能直接貼在公開留言區,我只能用私訊(DM)偷偷傳給原 PO 看」。
這個小細節揭示了一個在隱私心理學上極其重要的時間差:人們的隱私警覺,往往不是在「輸入文字給 AI」的那一刻發生的,而是在「看見自己的碎片被 AI 重新組裝成一張全知圖像」的那一刻才突然驚醒。
平常我們跟 AI 聊天時,感覺像是在一個沒有人的樹洞裡自言自語。今天問一個健康問題,下週問一個稅務問題,下個月聊一點感情煩惱——因為每次對話都是分開的文字視窗,我們在心理上會產生一種「碎片化安全感」,覺得每一件事都沒什麼大不了。直到「填滿房間」這個指令像磁鐵一樣,把你過去一年所有散落的鐵屑全部吸到同一個畫面裡,你才第一次用「旁觀者」的視角驚覺:原來把這些小事拼在一起,我整個人在系統面前竟然是如此透明。
第三齣戲:「這根本不是我,這是樣品屋吧!」(模板化與巴納姆效應的破功)
當然,並不是每個人都覺得 AI 很準。在同一個 Reddit 討論串中,也有不少網友貼出圖片後大呼失望。有人發現自己跑出來的圖片,構圖跟原發文者的範例圖幾乎長得一模一樣;還有另一位背景、性別、職業完全不同的網友附和說:「對!我跟你的生活毫無交集,為什麼我們的房間看起來像同一個設計師裝潢出來的?」甚至有人吐槽:「為什麼 ChatGPT 這麼迷戀在牆上貼滿軟木塞板、便利貼跟發光字卡?」
這種「看起來很個人化,仔細比對卻發現大家都長得差不多」的現象,戳破了生成式 AI 的一層神話。當你的記憶庫資料不夠豐富,或者當繪圖模型過度依賴它內建的視覺慣例時,它就會拿出算命仙最擅長的「巴納姆效應」(Barnum Effect)——塞給你一盞溫暖的黃光檯燈、幾本看不清書名的精裝書、一杯冒著熱氣的咖啡、一盆綠色植物和一台筆電。因為現代都市裡幾乎每個用電腦工作的人都喝咖啡、都用筆電、都希望房間裡有植物,你看了自然會覺得「哇,好有我的感覺」,但其實那只是演算法算出來的「現代知識分子最大公約數」。
第四齣戲:「我以為是禪意書房,網友說是靈堂」(社群的二次改寫與吐槽)
當這張圖片被貼上 Threads、Facebook 或 Dcard 後,第四齣戲才真正開演:觀眾進場了。
就像開頭提到的那個 Dcard 經典案例,發文者平常可能常跟 AI 聊佛學、節氣、花藝、茶道與閱讀,當 AI 把佛像、經書、鮮花、木桌與暖光全部塞進同一個房間時,發文者帶著對自我生活的認同,將它解讀為充滿靈性的「陽光禪意花園書房」。但路過的網友沒有那些對話脈絡,他們只看到正中央的佛像配上兩排對稱的鮮花與素雅木桌,立刻無情地留言:「這看起來根本像葬禮現場。」
這正是社群時代最真實的互動寫照:AI 生成了第一層自我敘事,你自己賦予了第二層浪漫解讀,而社群留言區的吐槽(Roast)則瞬間製造出第三層社會敘事。 我們玩這個遊戲,表面上是在跟 AI 互動,實際上卻是拿著 AI 畫出來的考卷,去社群廣場上跟朋友對答案、討拍、自嘲,並在眾人的笑聲與按讚裡,微調我們在群體中的人設。
照鏡子的心理學:當演算法成為我們的「第三雙眼睛」
要真正理解為什麼一張 AI 畫的房間會讓人看得入迷、甚至在心裡激起漣漪,我們不妨用一個最日常的比喻來思考:
傳統的自拍,就像你自己站在浴室鏡子前整理頭髮;但「用你對我的了解填滿房間」,卻像是請一位跟你同住一個屋簷下兩年、平常話不多、記憶力有點偏頗、但想像力異常豐富的室友,趁你出門時幫你重新佈置一間「他覺得最像你的房間」。
當你推開門看到成果的那一刻,你感受到的衝擊,同時包含了 「照鏡子」與「被他人凝視」 兩種截然不同的心理機制。
1. 從外部線索重新讀自己:自我知覺理論的數位延伸
在社會心理學中,康乃爾大學心理學家 Daryl J. Bem 在 1972 年提出的「自我知覺理論」(Self-Perception Theory)顛覆了一般人的直覺。我們通常以為,人是先在心裡很清楚「我是個什麼樣的人、我喜歡什麼」,然後才做出對應的行為;但 Bem 的研究指出,當我們的內在感覺有點模糊、不太確定的時候,我們其實會像一個「外部觀察者」一樣,回頭去觀察自己的外在行為與周遭環境,然後在心裡推論:「喔,我看起來每個週末都在做這件事,所以我應該真的很在乎它吧。」
把這個理論放到生成式 AI 的場景裡,事情就變得非常有意思了。
讓 AI 畫房間並不是 Bem 當年實驗室裡的經典情境,我們不能草率地宣稱「看 AI 畫圖就等於自我知覺效應」。但不可否認的是,生成式 AI 為現代人提供了一個前所未有的 「外部化線索來源」。
過去一年裡,你可能跟 ChatGPT 聊過五百次天,但你從來沒有把這五百次對話攤在桌上統計過。直到今天,AI 把這五百次對話濃縮成一張圖:你赫然發現房間正中央擺著四塊寫滿待辦事項的白板、桌上放著三杯冷掉的咖啡、牆角堆著五個寫著「未完成」的紙箱,而你自以為很重視的吉他跟畫架,卻只被塞在最陰暗的角落積灰塵。
看著這張圖,許多人腦中浮現的第一個念頭是:「天啊,原來我過去這半年跟它聊天的時候,滿腦子都只有工作跟焦慮嗎?」
在這一刻,AI 扮演了那個幫你「清點行為紀錄」的外部觀察者。當你對自己的生活狀態感到模糊或麻木時,AI 挑選出來的物件組合,就像一面把你的日常對話頻率具象化的放大鏡,逼著你從「AI 為什麼一直挑這些東西?」的反問裡,重新整理自己對生活重心的判斷。
2. AI 看見的不是「全部的你」,而是「你曾對它展演的你」
但就在我們快要被 AI 的「神準」說服時,必須立刻踩下煞車,退後一步問一個最根本的問題:AI 畫出來的,真的是「真實的你」嗎?
早在 2006 年,密西根大學與西北大學的傳播學者 Nicole B. Ellison、Rebecca D. Heino 與 Jennifer L. Gibbs 對線上交友平台使用者進行深度研究時就發現,人們在數位環境中呈現自我時,從來就不是在拍「客觀紀錄片」,而是在「印象管理」(想讓別人看到好的一面)與「真實自我」(不想騙人)之間不斷走鋼索,甚至會不自覺地把「理想中的自己」(Ideal Self)放進個人檔案裡。
到了生成式 AI 時代,正如史丹佛大學學者 Jeffrey T. Hancock、Mor Naaman 與 Karen Levy 在 2020 年提出的「AI 仲介傳播」(AI-Mediated Communication, AI-MC)理論框架所指出的,AI 已經不再只是幫我們傳遞訊息的電話線,而是會主動修改、篩選、濃縮甚至幫我們生成自我表述的「積極參與者」。
當你對 AI 下達「用你對我的所有了解填滿房間」時,系統所能調動的原料,從頭到尾都只有 「你曾經選擇開口跟 AI 說過的話」。
這意味著什麼?這意味著你生命中有大片大片的空白,是 AI 永遠看不見的:
- 你每天下班後默默照顧生病家人的疲憊,因為不需要請 AI 幫忙寫成企劃書,所以房間裡不會有這份溫柔與沉重;
- 你跟老朋友在熱炒店大笑暢飲的夜晚、你在海邊發呆看夕陽的午後,因為當下你根本不會打開手機跟 ChatGPT 聊天,所以在 AI 的記憶庫裡等於不存在;
- 反過來,你可能只是因為上個月幫公司籌備一場大型研討會,連續兩週每天瘋狂請 AI 幫你改講稿、寫信、排流程,結果 AI 的權重系統就誤以為「辦研討會」是你這輩子唯一的靈魂支柱,把你的房間畫得像個全天候運作的公關戰情室。
換句話說,AI 畫出來的房間,本質上是一張**「高度偏食的數位足跡切片」**。誰把工作交給 AI 處理,誰的房間看起來就像苦命社畜;誰只把 AI 當成深夜傾訴感情苦水的樹洞,誰的房間看起來就像充滿心碎符號的憂鬱閣樓。如果你忘了這層篩選機制,把「我在對話視窗裡的高頻提問」誤當成「我這個人生命的全部全貌」,就很容易掉進自我認知窄化的陷阱。
3. 當你把房間貼上社群,公開的展演會反過來變成你的一部分
更微妙的心理變化,發生在你按下「分享到 Threads / Instagram」的那一秒。
很多人以為,把 AI 畫的圖貼上網,就只是單純「給大家看看結果」而已。但傳播心理學家 Amy L. Gonzales 與 Jeffrey T. Hancock 在 2008 年關於「電腦仲介環境中的身份轉移」(Identity Shift)經典實驗中,早就證實了一個強大的心理機制:當一個人在公開的數位空間裡,將自己呈現為某種特質(例如外向或內向)時,因為知道「有觀眾在看」,他會比在私密日記裡寫下同樣內容的人,更強烈地把那個公開呈現出來的形象「內化」成自己真實性格的一部分。 他們在 2011 年針對 Facebook 個人頁面與自尊的研究也進一步發現,觀看並精心編輯自己在社群上的數位形象,會直接影響一個人當下的自我評價與自尊。
現在,讓我們看看一個普通網友在玩「填滿房間」時實際做了什麼:
- 他可能先叫 AI 畫了第一次,覺得畫面太普通、或者某個細節太丟臉,於是重新修正提示詞,連抽了三張圖;
- 他從這三張圖裡,挑出了一張「看起來最有質感、最符合我心中酷酷的自己、而且彩蛋夠好玩」的版本;
- 他在貼文寫下一段半自嘲、半得意的說明文字(「看來在 ChatGPT 眼裡我就是個離不開咖啡跟程式碼的工作狂呢」);
- 朋友們湧入留言區:「太像你了!」、「你就是這種人無誤!」
在這個過程裡,這張圖已經不再是單純的「AI 輸出結果」,而是經過你親手挑選、策展、並獲得朋友圈蓋章認證的 「公開身份承諾」。為了維持這個受歡迎的人設,你下次跟 AI 聊天、甚至下次在社群上發文時,都可能不自覺地更往這個「工作狂創作者」或「禪意生活家」的形象靠攏。
這正是整個現象最核心的 「三面鏡回饋循環」。我們每個人在看這張圖時,其實是同時站在三面鏡子中間:
flowchart TB
    A[第一面鏡:我說過的自己<br/>日常提問、工作草稿、深夜傾訴、記憶設定] --> D[AI 生成的演算法自我肖像]
    B[第二面鏡:模型推論的自己<br/>權重篩選、標籤壓縮、繪圖模型的視覺刻板印象] --> D
    C[第三面鏡:社群眼中的自己<br/>朋友按讚、尋寶解讀、無情吐槽、同溫層比較] --> E[我重新定義與理解自己]

    D --> E
    E --> F[後續行為調整:公開分享/修改記憶/揭露更多細節/刻意餵養人設]
    F --> A
這三面鏡子沒有一面是平面的光學鏡,它們全都帶著弧度與濾鏡。第一面鏡子濾掉了你不跟 AI 說的真實人生;第二面鏡子加上了演算法的偏見與繪圖模板;第三面鏡子則疊加了社群同溫層的期待與幽默感。當這三面鏡子的光線交疊在一起,投射出那間漂亮的房間時,我們很容易就被那個既像自己、又比現實生活更有戲劇張力的影像給迷住了。
「演算法平均化」與「信任—揭露螺旋」:兩個值得警惕的心理暗流
如果這場遊戲只停留在週末跟朋友笑一笑,那它不過就是數位時代的心理測驗或星座命盤。但因為生成式 AI 是一套每天與我們長期互動、甚至幫我們處理核心工作的系統,當我們開始習慣透過它來觀看自己時,有兩股在表面下湧動的心理暗流,非常值得我們拉響警鐘。
第一股暗流:當複雜的靈魂被壓縮成四種樣品屋——「演算法平均化」
你有沒有發現,不管參與這個迷因的人在現實生活中有多麼千奇百怪,最後在社群上洗版的 AI 房間,看起來卻總是逃不出幾種固定的「視覺套路」?
在本次研究分析中,我們提出一個待後續實證檢驗的概念,稱為 「演算法平均化」(Algorithmic Averaging)。這並不是傳統心理學教科書裡既有的名詞,而是用來描述生成式 AI 在將人類轉譯為圖像時的一種結構性傾向:模型會把一個原本充滿矛盾、曖昧、難以分類的複雜活人,強行壓縮成少數幾個高頻出現、而且在視覺上「最好畫、最討喜」的刻板角色原型(Archetypes)。
為什麼會這樣?這跟生成式 AI 的運作底層邏輯息息相關。
當文字模型讀取你的記憶摘要,要把它轉寫成繪圖指令(Image Prompt)時,它無法畫出「你在面對職涯轉換時那種既期待又怕受傷害、偶爾想躺平但又對品質有潔癖的微妙心情」。為了讓繪圖模型能順利產出圖片,它必須把這些複雜的心理狀態,簡化成繪圖資料庫裡最常見的視覺名詞:
- 只要你常問工作與寫作問題,你就立刻被歸類為 「都會知識工作者原型」=木質書桌+三台螢幕+散落的便利貼+馬克杯+書架;
- 只要你聊過畫畫、攝影或設計,你就變成 「文青創作者原型」=復古相機+顏料畫架+溫暖串燈+龜背芋盆栽+黑膠唱片機;
- 只要你問過運動或飲食控制,地上就一定會憑空長出啞鈴、瑜珈墊、乳清蛋白罐與水壺。
正如 Reddit 討論串中許多網友敏銳察覺到的:「為什麼每個人的牆上都有軟木塞推理板?為什麼每個人的房間看起來都像 Pinterest 上的北歐風加洛夫特風(Loft)樣品屋?」
在推薦系統的研究領域裡,學者早就警告過類似的機制。普林斯頓大學的 Allison J. B. Chaney、Brandon M. Stewart 與 Barbara E. Engelhardt 在 2018 年發表的模擬研究中指出,推薦演算法中的「演算法混淆」(Algorithmic Confounding)會導致不同使用者的消費行為越來越同質化(Homogeneity),抹平原本的多樣性。加州大學柏克萊分校的 Micah Carroll、Anca Dragan、Stuart Russell 等人在 2022 年發表於 ICML 的研究也進一步證明,演算法系統並不是在被動測量一個「固定不變的使用者偏好」,系統餵給你的內容會反過來誘導並改變你的偏好與內在狀態。
當然,推薦系統的數學模擬不能直接等同於畫一張 AI 房間圖。但它們指向了同一個深層危機:當我們反覆請演算法告訴我們「我是誰」,而演算法每次都只能用它詞庫裡那十幾種標準化的視覺積木來拼湊我們時,久而久之,我們會不會也開始用這十幾種扁平的標籤來理解自己,甚至為了讓圖看起來更漂亮,而削足適履地活成演算法最容易辨識的樣子?
第二股暗流:「它越懂我,我越敢脫光」——信任與揭露的螺旋循環
如果說「演算法平均化」影響的是我們看待自己的深度,那麼第二股暗流影響的,就是我們保護自己隱私的底線。
想像一下這個場景:你今天跟風玩了「填滿房間」,結果發現 AI 畫出來的房間裡,竟然少了你最引以為傲的單車環島經驗,反而放了一堆你早就沒在碰的舊工作資料。這時候,許多人會做一件非常自然的事——直接在對話框裡對 AI 說:
「不對啦!我早就不做那個專案了,我現在迷上的是公路車跟底片相機,而且我下個月要搬去臺中跟男友住了,你重新幫我畫一張!」
你有沒有注意到剛剛發生了什麼事?為了讓 AI 畫出一張「更準、更像我、貼出去更好看」的自畫像,使用者主動把更多原本沒有輸入系統的真實人生細節(感情狀態、搬遷計畫、最新嗜好),親手餵進了 AI 的記憶庫裡。
這形成了一個極具研究價值的行為閉環:
flowchart LR
    A[我向 AI 揭露日常與偏好] --> B[系統累積個人化記憶脈絡]
    B --> C[AI 挑選線索並生成自我肖像]
    C --> D{我看完圖後的心理反應}
    D -->|「太準了!它好懂我」| E[產生親近感與高信任感]
    D -->|「畫錯了!這不像我」| F[為了校正它而補充更多真實細節]
    D -->|「意外但很有啟發」| G[重新思考並認同該特質]
    E --> H[貼上社群分享並獲得朋友回饋]
    F --> B
    G --> H
    H --> I[為了獲得下次更好的互動與個人化體驗]
    I --> J[降低戒心、主動揭露更深層的個人資料]
    J --> A
這絕非憑空想像的危言聳聽。在 2026 年 3 月發表於《Cyberpsychology: Journal of Psychosocial Research on Cyberspace》的一項最新實證研究中,學者 Jing Niu、Bilal Mazhar、Yilin Ren 等人針對 1,034 名生成式 AI 使用者進行了結構方程模型分析。他們的研究結果非常清晰地量化了這個心理機制:
- 當使用者覺得生成式 AI 展現出越高的「感知同理心」(Perceived Empathy,也就是覺得 AI 很懂我、很能體察我的脈絡)與「感知自主性」(Perceived Autonomy)時,使用者對 AI 的信任感就會顯著上升,同時對個人資料外洩的隱私疑慮則會顯著下降;
- 更關鍵的是,在決定使用者「願不願意向 AI 揭露更多個人私密資訊」(Disclosure Intention)的模型裡,信任感具有正向推動力,而隱私疑慮的下降則具有極為強烈的影響力。
雖然 Niu 等人的研究屬於橫斷面調查,不能直接當成長期因果關係的鐵證,但它揭示了一個非常真實的人性弱點:「被理解的溫暖感」是隱私戒心最強效的麻醉劑。
當一張溫暖、精緻、充滿專屬小彩蛋的房間圖片出現在螢幕上時,那種「全世界只有它默默記住我所有小習慣」的親密錯覺,會瞬間瓦解我們對科技巨頭資料庫的防備。我們會忘記背後是一套雲端伺服器與權重矩陣,心甘情願地為了換取下一次更驚豔的個人化回饋,把自己的工作機密、心理創傷、家庭關係與健康狀況,一點一滴地搬進那個看似只屬於我們兩個人的虛擬房間裡。
綜合前面所有的心理學分析,我們可以把參與「演算法自我肖像」可能帶來的六種心理作用——包含它的正面價值與潛在暗礁——整理成一張清楚的對照表:
| 心理維度 | 對使用者的正面價值(光亮面) | 潛藏的心理與認知風險(陰影面) |
|---|---|---|
| 1. 自我辨識 (Self-Recognition) |
幫助自己在忙碌麻木的生活中,一眼看見近期反覆出現的核心主題與關注焦點。 | 頻率偏誤:把「最常請 AI 幫忙處理的瑣事」,誤認為「我人生最重要的核心價值」。 |
| 2. 自我距離化 (Self-Distancing) |
把內在的焦慮、拖延或強迫習慣變成畫面裡幽默的擺設(如 Overthinking.exe),用輕鬆一笑減輕心理壓力。 |
過度詮釋:把繪圖模型隨機生成的視覺比喻或幻覺,當成權威的心理診斷或命定特質。 |
| 3. 身份試演 (Identity Play) |
透過博物館、RPG 技能樹、主題樂園等不同容器,安全地想像並體驗不同面向的自己。 | 公開人設內化:為了迎合社群讚數而挑選特定形象,久而久之被自己公開展演的刻板人設綁架。 |
| 4. 社會連結 (Social Connection) |
作為絕佳的社交破冰話題,讓朋友在留言區找彩蛋、互相吐槽,增進同溫層的互動樂趣。 | 社會比較與意外赤裸:看著別人豐富精采的房間產生自卑感,或被眼尖網友從背景細節挖出不想公開的私事。 |
| 5. 系統校正 (System Calibration) |
藉由畫面錯誤發現 AI 記錯了哪些事,趁機清理過時記憶,重新奪回個人化設定的主導權。 | 校正型過度揭露:為了讓 AI「畫對、更懂我」,不自覺地輸入更多原本不該交給雲端系統的私密個資。 |
| 6. 創意反思遊戲 (Creative Reflection) |
將原本枯燥的自我探索變成零門檻、高趣味的視覺遊戲,激發對生活空間與自我的想像。 | 演算法平均化:在高度模板化的視覺語法中,把千篇一律的「樣品屋美學」當成深度的自我理解。 |
從這張對照表可以看出來,真正決定這場遊戲是「有益的自我反思」還是「危險的心理陷阱」的關鍵,從來就不是 AI 畫得準不準,而在於我們能不能清楚意識到 「三個落差」(Three Gaps) 的存在:
- AI 與自我的落差(AI-Self Gap):「AI 根據演算法畫出來的我」跟「我內心真正認同的我」之間的距離;
- 公開與私密的落差(Public-Self Gap):「我敢貼到 Threads 上給大家按讚的那張圖」跟「我私下覺得最準、卻絕對不敢發出去的那張圖」之間的距離;
- 資料與現實的落差(Data-Self Gap):「AI 能從聊天文字紀錄裡窺見的我」跟「離開螢幕後在真實世界裡呼吸生活的我」之間的距離。
只要你能看見這三道縫隙,這張圖就是一面能幫你激發思考的趣味哈哈鏡;但如果你以為這三道縫隙不存在,把畫面當成百分之百的自己,那你就等於把定義自我的畫筆,雙手奉送給了演算法。
如果我們要認真研究這股風潮:一套結合資料科學與心理學的八週行動藍圖
聊完了現象與背後的心理學機制,許多對數位文化、媒體心理學或人機互動感興趣的讀者可能會問:「截至目前為止,這些分析聽起來都非常有道理,但如果我們想把它從『有文獻支撐的觀察假說』,推進到『經得起學術界嚴格檢驗的實證結論』,我們該怎麼做?」
沒錯,必須誠實地說:雖然我們前面引用了 Bem 的自我知覺理論、Gonzales 與 Hancock 的身份轉移研究、Lee 等人的演算法水晶與 2026 年演算法自畫像研究,以及 Niu 等人在 2026 年對生成式 AI 揭露意圖的調查,這些堅實的學術積木足以解釋每個環節「為什麼可能發生」;但截至 2026 年 10 月底,全球還沒有任何一篇經過同行評審(Peer-Reviewed)的實證論文,直接針對「2026 年秋季這波 ChatGPT 空房間迷因」進行大規模的追蹤與因果檢驗。
因此,我們在完成這份探索性桌面研究(Desk Research)的同時,也同步規劃了一套可以直接落地的**「混合方法研究設計」(Mixed-Methods Research Design)**。這不僅是給學術研究者與實驗室的參考藍圖,也能讓一般讀者看懂:社會科學家是如何像偵探一樣,把網路上熱鬧滾滾的迷因,變成嚴謹、可驗證、又不侵犯他人隱私的科學證據。
1. 為什麼不能只看「最紅的那幾篇貼文」?——四層資料抽樣架構
在研究社群迷因時,最容易犯的錯誤就是「倖存者偏差」:如果研究者只打開 Threads 或 X,隨手抓演算法推到最上面的那 20 篇高讚數爆紅貼文來分析,最後得出來的結論一定會嚴重失真——因為那些會爆紅的房間,通常不是畫得特別美、彩蛋特別好笑,就是發文者本身就是網紅。那些覺得「畫得一點都不準」、「看起來好無聊」或是「嚇到不敢貼出來」的沉默大多數,就會在研究裡徹底消失。
為了克服這個盲點,加上我們在前期探索時發現各平台有不同的技術限制(例如直接用爬蟲開啟 X 原頁面常會遇到 403 Forbidden 阻擋、Threads 高頻讀取會觸發 429 Too Many Requests 流量限制,而 TikTok 則有嚴格的 robots.txt 爬蟲規範),正式研究必須採取 「搜尋索引與公開頁面交叉比對」,並結合以下四個層次的混合抽樣(注意:以下數字是為期八週的正式研究計畫建議規格,而非本次前期桌面觀察已完成的樣本數):
| 研究資料層級 | 建議樣本規模 | 抽樣策略與平台配置 | 核心研究目的與解答的問題 |
|---|---|---|---|
| 第一層:公開社群貼文 (Public Posts Content Analysis) |
600 則 | 跨五平台分層抽樣:X (150 則)、Threads (150 則)、Reddit (120 則)、TikTok (120 則,依公開可檢視頁面與跨平台引用抽樣)、Dcard (60 則)。依四個時間窗與高/中/低互動量進行系統抽樣。 | 全面盤點提示詞變體、14 種視覺容器比例、在地化語法(「不要真人」、「誇張一點」)、隱私防禦字眼與畫面物件特徵。 |
| 第二層:公開留言互動 (Public Comments Analysis) |
約 1,000 則 | 從上述貼文中選出 50 篇具代表性的錨點貼文(Anchor Posts),每篇各抽取「最高互動前 10 則」與「依時間序隨機 10 則」共 20 則留言。 | 捕捉觀眾如何參與「第三面鏡」的解讀:分析驚喜認同、毛骨悚然(Creepy)、幽默吐槽(Roast)與隱私提醒的比例。 |
| 第三層:深度半結構訪談 (In-Depth Interviews) |
約 36 人 | 採「最大差異取樣」(Maximum Variation Sampling):涵蓋不同年齡層、AI 使用頻率、有無公開貼圖(含「生成後不敢貼」者)、以及對結果滿意度高與低的使用者。 | 重建使用者從「輸入指令前、看見畫面瞬間、決定是否分享、到事後調整記憶」的完整內在心理歷程。 |
| 第四層:結構化問卷與實驗 (Survey & Randomized Experiment) |
問卷 800 人 實驗 180 人 |
問卷採人口統計與 AI 使用經驗配額抽樣;實驗則將 180 名受試者隨機分為三組(每組 60 人),測試不同隱私與透明度提示詞的效果。 | 以統計模型檢驗「準確感、信任、隱私疑慮、分享意圖、自我概念改變」之路徑關係,並透過實驗確立因果機制。 |
在抽取那 600 則公開貼文時,為了避免被單一時間點的熱度綁架,我們設計了 「四個時間窗 × 三種互動量」 的網格:
- 前驅期(2026 年 9 月 26 日以前):如 Reddit 8 月底的 30 種提示詞長串與早期實驗;
- 首波引爆期(9 月 27 日至 10 月 10 日):Kris Kashtanova 發出空房圖後的英語圈首波擴散;
- 跨平台高峰期(10 月 11 日至 10 月 17 日):AI Op Zak 記錄到的第二波高峰,以及 Instagram、Facebook 教學模板成形期;
- 在地化與長尾期(10 月 18 日以後):繁體中文社群(Threads、Dcard)加入「不要真人圖片、誇張一點」的百花齊放期。
針對每一則抽取出來的貼文,研究團隊不能只憑感覺看過去,而必須像做體檢一樣,由兩位獨立的研究編碼員(Coders)根據嚴格定義的「編碼簿」(Codebook),逐一登記 11 個關鍵欄位:
- 使用的提示詞容器類型(空房間、OS、冰山圖等);
- 是否明示要求調用系統記憶或歷史對話(Memory / Past Conversations);
- 是否包含「不要出現真人/人物」的限制;
- 是否包含「排除深度個資」的隱私邊界;
- 畫面中物件的具體程度(是籠統的「書本」,還是看得出書名的特定專業書);
- 畫面中是否夾帶可閱讀的文字標籤(便條紙、螢幕字樣、海報字卡);
- 是否意外出現「第三人資訊」(伴侶、小孩、同事、客戶的線索);
- 原發文者是否在內文中評價結果「很準」;
- 內文或留言是否出現驚喜(Surprise)、毛骨悚然(Creepy)或吐槽(Roast)敘事;
- 發文者的主要社交意圖(自我反思、展示品味、尋求共鳴或純粹跟風)。
兩位編碼員會先拿 50 則貼文進行試編碼(Pilot Coding),修正定義不清楚的地方,直到兩人的判斷一致度指標(Cohen's kappa 係數)達到 .80 以上的高標準,才會展開正式編碼。
2. 當 AI 成為研究助手:兼具效率與倫理的「人機協作去識別化流程」
在處理這上千則貼文與圖片時,現在的研究團隊當然也會利用大型語言模型(LLM Agents)來幫忙整理資料。但這馬上會衍生出一個嚴肅的研究倫理問題:如果我們直接把網友公開貼在 Threads 或 Dcard 上的房間圖片與帳號名稱丟給 AI 分析,甚至直接放進研究報告裡公開展示,我們會不會反而成為侵犯網友隱私的幫兇?
要知道,在研究倫理上,「網友自己設為公開貼文」絕對不等於「研究者可以把他的帳號、房間細節與生活隱私永久印在學術報告裡供人肉搜」。更何況,研究者也絕對不應該去刺探任何私人訊息(DM)、不公開社團或已被作者刪除的貼文。
因此,我們設計了一套嚴格的 「多代理人處理與人類雙重覆核流程」(Multi-Agent & Human-in-the-Loop Pipeline)。在這套流程裡,AI 代理人(Agents)只負責當初步的資料篩選與打碼工人,絕對不能讓 AI 自己決定哪些個資可以公開:
flowchart LR
    A[Collector Agent<br/>依關鍵詞蒐集公開候選貼文] --> B[Provenance Agent<br/>核對發布日期/平台/原始連結]
    B --> C[Privacy Agent<br/>自動遮蔽帳號、頭像與圖內文字個資]
    C --> D[Coding Agent<br/>依編碼簿進行初步特徵分類]
    D --> E[Psychology Agent<br/>標記潛在心理構念與情緒敘事]
    E --> F[Human Adjudication<br/>兩位人類研究者逐筆覆核與修正]
    F --> G[建立完全去識別化之研究資料集]
    G --> H[量化統計與結構方程分析]
    G --> I[質性主題與視覺符號分析]
    H --> J[三角檢證 Triangulation]
    I --> J
    J --> K[產出最終研究報告(零個資暴露)]
這套流程最關鍵的守門員是第三步的 Privacy Agent 與第六步的 Human Adjudication(人類裁決)。任何一張圖片或貼文進入分析資料庫前,帳號 ID、大頭貼、畫面裡不小心拍到的真實姓名、公司標誌、學校名稱或罕見的個人特徵組合,都會被先一步打碼與抽象化,確保最後進到統計與質性分析階段的,是一份乾淨、安全、無法反查出特定自然人的去識別化資料集。
3. 怎麼問才不會引導受訪者?——八個直擊內心的訪談提問與隨機實驗
在質性訪談階段,最忌諱研究人員拿著麥克風直接問受訪者:「你覺得 AI 是不是看透了你的靈魂?」、「看完這張圖之後,你是不是更認識自己了?」這種充滿暗示與引導性的問題,只會讓受訪者順著你的話點頭,問不出真實的心理運作。
真正高明的訪談,是引導受訪者像倒帶一樣,自己把當時「心裡怎麼想、眼睛先看哪裡、為什麼決定刪掉某張圖」的判斷歷程重新演一遍。在我們的設計中,訪談大綱聚焦在八個不帶預設立場的核心問題:
- 生成前的預期基線:「在按下生成按鈕以前,你原本以為 AI『記得你哪些事』?有沒有哪些事是你以為它早就忘了、或者根本不會注意到的?」
- 第一眼認同錨點:「當圖片跑出來的那一秒,畫面裡『第一個』讓你覺得『哇,這真的很像我』的物品或細節是什麼?為什麼是它?」
- 美麗的誤會與合理化:「圖裡面有沒有哪個細節其實『跟事實不符』(例如畫了你根本沒去過的國家或沒養過的寵物),但你看了卻覺得『好像也有點道理、滿符合我的感覺』?」(這題能精準捕捉人們是如何把 AI 的幻覺合理化成自我敘事的。)
- 缺席的自我:「在現實生活中對你非常重要的一塊自己,有沒有完全沒出現在這張圖裡?當你發現它不見時,你是怎麼跟自己解釋這個缺席的?」
- 事後的校正與餵養行為:「看完結果之後,你有沒有忍不住再去修改提示詞、開口糾正 AI、進去設定裡刪掉某些記憶,或者反過來多告訴它一些你的事情?」
- 私密與公開的篩選標準:「如果這張圖只有你自己一個人看,跟你要把它貼到 Threads 或 IG 給朋友看,有哪些細節是你『自己看很開心,但絕對不想貼出去』的?你心裡那條線是怎麼畫的?」
- 第三人資料的倫理直覺:「如果 AI 在房間裡畫出了跟你的伴侶、小孩、同事、任職公司或健康狀況有關的線索,你在當下會覺得『這是我的資料』,還是會覺得『這好像涉及了別人的隱私』?」
- 人機來源歸因測試:「假設今天完全一模一樣的房間描述,不是 AI 畫出來的,而是你認識三年的好朋友親手寫給你的,你相信它的程度、或是你解讀它的方式會有什麼不一樣?」
而在量化問卷與實驗設計上,除了用 1 到 7 分的李克特量表(Likert Scale)去測量「感知準確度」、「自我認同感」、「驚喜感」、「被監看恐懼感(Creepiness)」、「AI 信任度」、「隱私疑慮」、「公開分享意圖」、「進一步揭露意圖」、「修正 AI 記憶意圖」與「生成後自我觀點改變」這十個核心心理變項之外,最精彩的設計在於 「三組隨機對照實驗」。
我們可以招募 180 名平常都有在使用 ChatGPT 的參與者,在控制他們使用相同帳號背景的前提下,隨機將他們分配到三個不同的提示詞組別:
- A 組(一般跟風組):直接輸入網路上最流行的原版指令——「用你對我的所有了解填滿這個房間,不要出現真人圖片。」
- B 組(隱私邊界組):輸入加上防護罩的指令——「用你對我的所有了解填滿這個房間,不要出現真人圖片,且排除深度個資、第三人資訊與精確地點。」
- C 組(可追溯透明組):除了包含 B 組的隱私限制外,多加一個「先審後畫」的步驟——要求 AI 先用文字條列出它準備採用的個人線索清單,並逐條標註哪些是「你明確說過的」、哪些是「系統合理推論的」,讓使用者親自打勾同意後,才生成圖片。
這個實驗一旦跑完,就能直接用科學數據回答三個連 AI 產品設計師都想知道的關鍵問題:
- 隱私與準確感的權衡:加上嚴格的隱私保護(B 組)之後,使用者會不會覺得畫出來的房間變無聊了,犧牲了「被 AI 理解」的感動?
- 透明度的信任加成:讓使用者事先看到 AI 拿了哪些記憶來畫圖(C 組),究竟會因為「原來它是根據這句話推論的」而大幅提升信任感?
- 未知與恐懼的關係:當黑盒子被打開、所有線索來源都變得可追溯時,那種毛骨悚然的「被監看感」(Creepiness)究竟會因此降低,還是會因為親眼看到長長的記憶清單而反而升高?
甚至在實驗控制上,我們還可以進一步把 「內容線索變異」與「美術風格變異」拆開來控制。什麼意思呢?有時受試者覺得第二張圖「比第一張更像我」,其實根本不是因為第二張圖的個人化線索比較準,純粹是因為第二張圖的光影比較美、配色比較溫暖!因此,在嚴謹的實驗室設計裡,我們可以先固定同一份經過受試者核准的「個人事實清單」(Personal Evidence Set),然後只用隨機種子(Seed)去改變畫面的情緒基調(荒謬/溫暖/神秘/冷靜)與視覺構圖(電影感透視/3D 等角模型/復古海報/高密度拼貼)。如此一來,我們才能百分之百確定,受試者心裡的感動或抗拒,到底是因為「AI 怎麼描述我這個人」,還是單純被華麗的畫風給收買了。
如果從 2026 年 10 月 26 日開始啟動這項為期八週的研究計畫,整個團隊的推進節奏會是這樣環環相扣的:
gantt
    title 「AI 如何畫出它認識的我」八週混合研究推進藍圖
    dateFormat  YYYY-MM-DD
    axisFormat  %m/%d

    section 階段一:基礎建置
    文獻回顧與研究假說定錨         :a1, 2026-10-26, 10d
    跨平台搜尋策略與編碼簿制定     :a2, 2026-10-29, 10d
    50則貼文前導試編與信度檢驗     :a3, 2026-11-05, 7d

    section 階段二:社群大數據
    五平台600貼文與1000留言蒐集    :b1, 2026-11-02, 21d
    去識別化打碼與雙人獨立編碼     :b2, 2026-11-09, 24d

    section 階段三:使用者實證
    36人最大差異抽樣與深度訪談     :c1, 2026-11-16, 21d
    800人問卷調查與180人三組實驗   :c2, 2026-11-23, 14d

    section 階段四:整合產出
    量化路徑模型與質性主題分析     :d1, 2026-11-30, 12d
    多源資料三角檢證與理論模型修訂 :d2, 2026-12-07, 7d
    研究報告撰寫與倫理合規最終審查 :d3, 2026-12-10, 11d
透過這套從社群觀察、深度訪談到隨機實驗的完整設計,我們就能把一個原本看似轉瞬即逝的網路流行語,轉化為理解人類與生成式 AI 長期共生關係的重要里程碑。
「沒有畫出我的臉,就代表沒有洩漏個資嗎?」:你必須知道的隱私真相與自保指南
這整份研究最核心、也最迫切需要傳達給每一位讀者的倫理結論,其實可以用一句話講完:
在提示詞裡加上「不要出現任何真人圖片」,只能幫你擋掉臉孔、身材與生物特徵的直接暴露,絕對不等於「這張圖沒有個資風險」。
為什麼這麼說?因為在資訊安全與法律的世界裡,有一個概念叫做 「間接識別」(Indirect Identification),也就是俗稱的「拼圖效應」。
翻開我國的《個人資料保護法》第 2 條第 1 款,法律對「個人資料」的定義寫得非常清楚:除了姓名、出生年月日、身分證字號、指紋這些一眼就能認出你的直接資料之外,還包含了**「婚姻、家庭、教育、職業、病歷、醫療、基因、性生活、健康檢查、犯罪前科、聯絡方式、財務情況、社會活動及其他得以直接或間接方式識別該個人之資料」**。同時,《個人資料保護法》第 5 條也明文規定,個人資料之蒐集、處理或利用,不得逾越特定目的之必要範圍;而第 6 條更將醫療、基因、性生活、健康檢查及犯罪前科列為原則上不得蒐集處理利用的特種(敏感)個資。
讓我們把法條翻譯成你我身邊的真實場景。
假設今天有一張完全沒有半個人影、畫風溫馨可愛的「AI 書房圖」被貼在 Threads 上。但是,因為這位使用者平常把 ChatGPT 當成全能生活助理,什麼都跟它聊,結果 AI 非常盡責地把所有記憶細節都塞進了畫面裡:
- 牆上的錦旗或馬克杯印著某國立大學特定系所的縮寫;
- 書桌上的螢幕顯示著某個罕見跨國研究計畫的英文簡稱;
- 窗外畫出了特定城市的地標天際線;
- 書架上擺著兩樣極度冷門的特殊收藏品;
- 桌角放著某種特定慢性疾病或心理治療的藥盒,旁邊還壓著一張寫有伴侶英文小名與紀念日的卡片。
請問,把這五、六個線索單獨拆開來看,哪一個能直接認出他是誰?都不能。但當這六個線索同時出現在同一個房間裡時,只要是認識他的同事、學生、甚至是有心肉搜的陌生網友,可能不需要花三分鐘,就能精準鎖定:「這不就是某某大學那個誰的房間嗎?原來他最近在吃這種藥、原來他跟誰在一起!」
正如中央研究院近期針對生成式 AI 個資保護邊界與難題所發布的專欄分析與中研院生成式 AI 風險研究小組報告所提醒的,生成式 AI 在個資上面臨的是雙重夾擊:一方面,模型的「記憶」機制可能會在未經充分授權或超出預期的情境下,把真實的私密個資重新組合輸出;另一方面,模型的「幻覺」(Hallucination)機制又可能無中生有,把錯誤的個人特徵硬安在當事人頭上,讓人百口莫辯。
被遺忘的「第三人隱私」:你的彩蛋,可能是別人的祕密
除了你自己可能被肉搜之外,還有一個幾乎所有跟風玩家都忽略的盲點:第三人隱私問題(Third-Party Privacy)。
仔細想想,在你的日常生活裡,你跟 AI 聊的真的只有「你自己」嗎?
- 當你請 AI 幫你寫一封安撫伴侶情緒的長信時,你把伴侶的性格弱點與原生家庭矛盾告訴了 AI;
- 當身為主管或老師的你,請 AI 幫你想辦法輔導一位表現失常的下屬或學生時,你把對方的狀況輸進了對話框;
- 當你請 AI 幫你回覆奧客的客訴信、整理部門會議紀錄、或是規劃帶年邁父母看診的行程時,你的客戶、同事與家人的資訊,全都進了「AI 對你的了解」的一部分。
當你今天興沖沖地對 AI 下令「用你對我的所有了解填滿房間」時,你的伴侶、你的孩子、你的學生、你的同事、你的客戶與你的主治醫師,從來沒有人簽過同意書,答應要變成你社群貼文裡的「背景視覺彩蛋」。如果 AI 把你伴侶的私密困擾畫成牆上的隱喻畫作,或是把你正在處理的客戶專案名稱直接印在畫面的電腦螢幕上,那一張圖貼出去,傷害的就不只是你一個人的隱私了。
搞懂系統怎麼「記住你」:ChatGPT 的兩層記憶機制
為了不讓自己在不知不覺中「裸奔」,我們也必須花兩分鐘搞懂:當我們要求 AI 調用「對我的所有了解」時,系統到底去哪裡翻出了這些舊帳?
以目前最多人用來玩這個迷因的 ChatGPT 為例,根據 OpenAI 官方說明中心關於 Memory(記憶功能)的最新文件,系統的個人化記憶其實分成兩個截然不同的抽屜:
- 參照歷史對話(Reference chat history):當這個開關打開時,ChatGPT 可以跨越單一聊天室的界線,去翻找你過去所有歷史對話裡的相關資訊來做個人化回應。這種記憶會隨著你近期的聊天重心而動態更新。如果你把這個開關關掉,系統從歷史對話裡歸納出來的印象會在 30 天內排程刪除,但原本的歷史對話紀錄本身還是會留在你的帳號裡,除非你手動刪除那些對話。
- 已儲存的記憶(Saved memories):這是你明確下令叫 ChatGPT「記住這件事」,或是系統自動判斷「這是重要背景資訊」而獨立寫進記憶筆記本裡的條目。最關鍵的陷阱在這裡:「已儲存的記憶」跟「原始聊天紀錄」是分開存放的!這意味著,就算你事後覺得某次聊天太私密,跑去把那個聊天室整個刪掉(Delete chat),只要當時某個細節已經被寫進了「已儲存的記憶」,它就不會跟著聊天室一起消失——你必須親自進到「設定 → 個人化 → 管理記憶」裡面把那條記憶刪掉,或者在對話中明確命令它忘掉。
此外,根據 OpenAI 關於資料控制(Data Controls)與暫時聊天(Temporary Chat)的官方指南,如果你接下來要問的事情非常敏感(例如醫療症狀、財務糾紛或公司機密),從一開始就不想讓它變成未來「填滿房間」的材料,最治本的做法是直接開啟「暫時聊天」(Temporary Chat)——在這個模式下,對話不會留在歷史列表、不會建立或更新任何系統記憶,也不會被拿去訓練或改進模型。(當然,不同家的生成式 AI 如 Claude、Gemini 等各有不同的記憶與資料保存規則,使用前都應先查看各平台的個人化設定。)
貼文前的安全閥:「四問判準」與「紅黃綠三色分級」
那麼,我們到底該怎麼聰明地玩這個遊戲,既能享受請 AI 畫出自我肖像的反思樂趣,又不會把自己的身家底細跟親友隱私賣掉?
我們建議所有使用者在生成圖片、尤其是準備把圖片貼上公開社群之前,先在心裡跑一遍極度好記的 「四問同意判準」:
- 這是只屬於我一個人的資料嗎?(有沒有牽涉到伴侶、家人、同事、學生或客戶?)
- 為了讓這張圖好玩,真的需要放進這麼具體的真實名稱嗎?
- 畫面裡被波及到的其他人,會合理預期這件事被畫出來貼在網路上嗎?
- 如果一個不認識我的陌生人,把圖裡這五個小彩蛋拼湊在一起,能不能反推出我是誰、住哪裡、在哪上班?
只要這四個問題裡面,有任何一題你的答案是「不太確定」,那就代表這張圖在公開分享前,必須先經過「抽象化降敏處理」。
在實務操作上,你可以用最簡單的 「紅黃綠燈三色分級表」 來管理你餵給 AI 的個人線索:
| 安全燈號 | 包含的資訊類別 | 建議處理做法(私下自賞 vs. 公開貼文) |
|---|---|---|
| 🟢 綠燈區 (安全可公開) |
廣泛的興趣類別(如喜歡科幻小說、手沖咖啡、慢跑)、非敏感的生活偏好、一般性的工作型態、虛構的幽默象徵物。 | 可直接轉化為具體物件:無論是自己收藏還是貼上 Threads / IG 與朋友互動,風險都極低。 |
| 🟡 黃燈區 (需抽象化降敏) |
任職公司或就讀學校名稱、居住城市、親密關係狀態、固定作息路線、罕見的專案主題、一般性的生活健康習慣。 | 私下版可斟酌,公開版必須「往上一層抽象化」:例如把「台大某研究所」改畫成籠統的「學術書籍」,把「特定公司專案」改成抽象的「發光能量水晶」。 |
| 🔴 紅燈區 (絕對禁區) |
精確住家地址或窗外真實街景、身分證件、電話與聯絡帳號、財務帳務、密碼、未公開之醫療病歷與用藥、任何可識別第三人之私密資訊。 | 不輸入、不生成、不公開:若發現 AI 記憶庫裡已有這類資料,應立即進入系統記憶設定手動刪除,絕不讓其進入圖像生成流程。 |
直接複製就能用!兩組「隱私優先版」中文提示詞模板
為了讓你不用自己傷腦筋怎麼跟 AI 談條件,我們把前面所有的隱私防護原則,直接濃縮成兩組你可以直接複製貼上的繁體中文提示詞(Prompt)。
第一組是 「深度反思自賞版」——適合你想看看 AI 有多懂你、想獲得具體彩蛋,但同時希望系統先讓你「審核線索清單」、不要亂猜也不要踩到個資紅線:
請根據你目前在對話與記憶中能確認、而且是我曾經主動透露的資訊,
把我呈現成一間充滿物件與象徵符號的房間。

【基本視覺限制】
不要出現任何人物、臉孔、身體或真人照片。

【嚴格隱私邊界】
請絕對不要使用或顯示以下資訊:
精確地點、住址、聯絡方式、帳號名稱、財務資料、
醫療或健康敏感資訊、真實文件或信件內容,
以及任何可以識別我的家人、伴侶、同事、學生、客戶或其他第三人的資訊。

【抽象化轉換原則】
如果我的工作單位、居住地點、人際關係或罕見經歷有可能讓人認出我是誰,
請自動將它們「往上一層抽象化」(例如用一般的「大學圖書館」、「科技實驗室」
或象徵性的奇幻物件,來取代真實的機構與專案名稱)。
畫面裡的物件可以幽默誇張,但請不要把你的推論當成既定事實;
不確定的部分請用抽象意象呈現。

【重要:先審核再畫圖】
在真正開始生成圖片之前,請先不要畫圖!
請先用文字把你準備放進房間的線索分成兩列:
1.「我明確說過的事實」
2.「你的合理推論與視覺轉譯」
讓我先檢視並確認沒問題後,你再開始生成圖片。
第二組則是 「社群公開打卡安全版」——如果你做這張圖的目的,從一開始就是要貼到 Threads、Instagram、Facebook 或 Dcard 上跟網友蓋樓互動,請務必使用這個最嚴格的防護版本:
我想做一張可以公開分享到社群媒體的「用你對我的了解填滿房間」圖片。

請只使用「粗粒度」的個人化資訊,例如我的廣泛興趣類別、一般工作型態、
思考習慣與抽象的價值觀。不要出現任何人物或真人照片。

請嚴格遵守以下安全規則:
1. 畫面中絕對不要出現任何真實人名、公司名、學校名、城市地名、日期或行程表。
2. 畫面中的書背、螢幕、便利貼、海報或紙張上,不要出現任何可清楚閱讀的真實文件、郵件、通知內容或帳號 ID。
3. 不要加入任何與我身邊親友、伴侶、同事等第三人有關的可識別資訊。
4. 請全部改用虛構的趣味書名、抽象圖示、無法反查真實身分的象徵物與誇張幽默的擺設來呈現。
除了用提示詞保護自己,如果你是一位喜歡在社群上分享 AI 玩法的創作者或一般玩家,我們也強烈建議你在按下「發布貼文」前,養成 「十秒鐘六步自我檢查」 的習慣:
- 底圖不拍真家:如果要上傳空房間底圖,請用 AI 先生成一張虛擬白房間,千萬不要拿手機直接拍自己真實住家的客廳或窗外街景上傳;
- 先看清單再產圖:養成請 AI 先列出參考線索的習慣,把關後再畫圖;
- 放大檢查文字:圖片生成後,一定要用兩根手指把畫面上的螢幕、白板、書背、獎狀與便利貼放大看清楚,確認沒有夾帶真實校名、公司名或人名;
- 區分「很準」與「能公開」:心裡永遠記得,「這張圖準到讓我起雞皮疙瘩」往往代表它塞了太多私密細節,越準的圖通常越只適合自己私藏;
- 加註娛樂免責聲明:貼文時順手寫一句「這是 AI 根據平常工作聊天的趣味誇張轉譯」,提醒觀眾(也提醒自己)這不是什麼客觀的人格診斷;
- 陌生人拼圖測試:最後問自己一次:「如果一個完全不認識我的路人,把圖裡這五個小彩蛋湊在一起,會不會拼出我原本不想讓陌生人知道的事?」
而從科技產品設計與平台治理的角度來看,我們也認為未來的生成式 AI 平台(如 OpenAI、Google、Anthropic 等),不應該把所有保護隱私的責任都推給使用者自己寫提示詞。當系統偵測到使用者輸入「用你對我的所有了解畫一張圖」(everything you know about me)這類高密度個人化視覺請求時,平台端其實非常適合內建五項 「隱私預設設計」(Privacy by Design):
- 生成前自動彈出記憶來源預覽:讓使用者一眼看到這張圖準備調用哪 5 條記憶,隨手一點就能取消勾選不想曝光的條目;
- 預設過濾高風險類別:系統底層自動將精確地址、醫療健康、財務數字與第三人姓名排除在繪圖提示詞之外;
- 提供一鍵切換「社群安全模式」(Social-Safe Mode):開啟後自動將所有具體專有名詞替換為上位抽象符號;
- 圖像文字安全掃描:在圖片輸出給使用者前,自動提醒畫面中是否包含可辨識的機構名稱或真實文字;
- 生成後的可解釋性標註:點選圖片上的特定物件時,能像看註解一樣,顯示「為什麼系統會在這裡放一隻烏龜?(來源:你於 2026 年 5 月的對話)」。
研究資訊透明化:核心檢索資源與六大研究限制
為了讓這篇文章不只是一篇讀起來痛快的趨勢評論,更能成為後續研究者、媒體工作者與學生可以隨時按圖索驥的知識基地,我們將本次研究過程中所核對的核心原始文獻、社群檔案與法規說明,依照 「原始社群與一手學術研究優先(A 級)、第三方趨勢報告與科普專欄補充(B 級)」 的嚴謹原則,整理成這份公開檢索指南:
| 優先級 | 核心文獻/資料來源名稱 | 在本研究中的角色與驗證用途 | 建議後續追蹤之精確檢索式與連結 |
|---|---|---|---|
| A | Kris Kashtanova (@icreatelife) 2026/09/27 X 原帖與隱私補充帖 |
確認 2026 年秋季「空房間」特定迷因之主要擴散起點,以及首日即出現之 Except deeply personal info 隱私邊界變體 |
搜尋式:"fill this room" "everything you know about me" @icreatelife(配合 AI Op Zak 考據頁交叉驗證) |
| A | Reddit r/ChatGPT 30 種個人化圖像提示詞原帖 (2026/08/28) | 建立廣義「演算法自畫像」之前驅歷史與 14 種非真人視覺容器之類型學分類基礎 | 搜尋式:"everything it already knows about me" "30 prompts"(Reddit 原文連結) |
| A | Dcard/Threads/Facebook 跨平台實例 | 驗證繁體中文在地化語法(「不要出現任何真人圖片」、「誇張一點」)及「禪意書房 vs. 葬禮」之社群二次解讀現象 | 搜尋式:「用你對我的所有了解」 房間 ChatGPT(Dcard 討論串連結) |
| A | Ellison, Heino & Gibbs (2006), Journal of Computer-Mediated Communication | 奠定數位自我呈現中「真實自我」與「理想自我」策略性協調之理論基礎 | 搜尋式:"Managing Impressions Online" Ellison Heino Gibbs(OUP 期刊連結) |
| A | Gonzales & Hancock (2008) / (2011) | 解釋公開數位自我呈現如何引發「身份轉移」(Identity Shift)並反過來影響自我概念與自尊 | 搜尋式:"Identity Shift in Computer-Mediated Environments";"Mirror Mirror Facebook Wall"(史丹佛論文 PDF) |
| A | Lee, Mieczkowski, Ellison & Hancock (2022), PACM HCI (CSCW) | 提出「演算法水晶」(Algorithmic Crystal)框架,解釋人們如何透過個人化演算法折射並理解自我 | 搜尋式:"The Algorithmic Crystal" TikTok self concept Lee(密西根大學論文 PDF) |
| A | Lee, Kim et al. (2026), ACM DIS 2026 | 最直接對應本研究之學術前驅:以「演算法自我肖像」(Algorithmic Self-Portraits)作為反思演算法自我落差之媒介 | 搜尋式:"Is This the Real Me" algorithmic self portraits(Semantic Scholar 頁面) |
| A | Hancock, Naaman & Levy (2020), JCMC | 建立「AI 仲介傳播」(AI-Mediated Communication)定義,解析 AI 代為生成自我表述之倫理與信任問題 | 搜尋式:"AI-Mediated Communication" Hancock Naaman Levy(OUP 期刊連結) |
| A | Niu, Mazhar, Ren et al. (2026), Cyberpsychology | 提供 1,034 名生成式 AI 使用者之實證模型,證實感知同理心、信任($\beta = .095$)與隱私疑慮($\beta = -.541$)對揭露意圖之影響 | 搜尋式:"Decoding user disclosure intentions in generative AI" Niu(期刊全文頁) |
| A | 我國《個人資料保護法》(全國法規資料庫) | 界定第 2 條「直接或間接識別個人資料」、第 5 條比例原則與第 6 條敏感特種個資之法律邊界 | 搜尋式:個人資料保護法 第2條 間接識別(全國法規資料庫連結) |
| A | OpenAI 官方說明中心:Memory 與資料控制指南 | 釐清 ChatGPT Reference chat history 與 Saved memories 之雙軌分離機制及 Temporary Chat 控制方式 |
搜尋式:site:help.openai.com memory ChatGPT reference chat history(OpenAI 官方指南) |
| B | AI Op Zak (2026/10/17) 空房間趨勢考據報告 | 獨立第三方交叉驗證 9 月 27 日首波起點與 10 月 11–13 日第二波擴散時間軸 | 搜尋式:"Empty room trend: what ChatGPT knows about you" AI Op Zak(報告原文連結) |
| B | 中央研究院專欄:生成式 AI 個資保護的邊界與難題 | 補充臺灣在地法制脈絡下,生成式 AI「記憶」與「幻覺」所衍生之雙重個資侵害風險 | 搜尋式:生成式AI 個資保護的邊界與難題 中央研究院(中研院專欄連結) |
最後,秉持科學研究最珍貴的「知之為知之,不知為不知」精神,我們也必須向讀者坦誠交代本次研究在資料取得與推論上的六項客觀限制:
- 社群平台的技術存取限制:在進行跨平台核對時,雖然搜尋引擎索引與第三方考據能清楚確認貼文內容與傳播節點,但直接讀取 X 原貼文頁面時常會遭遇
403存取阻擋,Threads 多個原始頁面也會回傳429請求過多限制。因此,我們能夠確證文字演變與時間線,但不會把當下動態變動的按讚數、轉發數或瀏覽量當作絕對精確的統計母體。 - TikTok 爬蟲規範限制:由於 TikTok 的
robots.txt嚴格限制自動化檢索,本次研究無法直接進場爬取 TikTok 內部的完整影片庫。我們雖能從 Threads 與 Instagram 貼文中使用者的自述(「我在 TikTok 看到這個玩法」),合理確認 TikTok 是這波傳播鏈的重要一環,但絕不妄下斷語去宣稱哪支 TikTok 影片是全網第一支爆款。 - 私密場域的不可見性(也不應強行窺探):正如前面 Reddit 網友所說的,最準、最勁爆的房間圖,往往都留在私人聊天室(DM)或摯友限時動態裡。研究者既沒有權限、也絕對不應該在未經同意下試圖擷取私人訊息或已刪除內容;這塊「冰山下的私密分享行為」,必須留待後續招募受試者進行知情同意訪談時才能一探究竟。
- 相對時間戳記的精確度保守原則:雖然搜尋引擎索引能推算出 Reddit 30 種提示詞原帖約發布於 2026 年 8 月下旬(頁面相對時間顯示為「約兩個月前」),但在無法直接檢視伺服器毫秒級原始時間戳記的情況下,最負責任的寫法是將其定錨於「2026 年 8 月下旬至 9 月初的前驅期」,而不去硬湊一個沒有鐵證的絕對日期。
- 每人背後「AI 記憶庫容量」的巨大差異:同樣輸入「用你對我的所有了解填滿房間」這十二個字,一個每天跟 ChatGPT 聊三小時、開啟完整 Memory 功能的兩年老用戶,跟一個剛註冊三天、幾乎沒聊過私事的新手,系統背後能調動的資料量根本是天壤之別。因此,在後續正式實驗中,絕對不能把「輸入同一個 Prompt」當成「接受相同的實驗刺激」,必須同步記錄受試者的記憶開關狀態、帳號使用年資、累積對話量與模型版本。
- 最重要的一條底線——相關不等於因果:雖然過去二十年的心理學與傳播學文獻(從 Bem (1972)、Ellison 等人 (2006)、Gonzales 與 Hancock (2008) 到 Lee 等人 (2022, 2026) 及 Niu 等人 (2026))已經為我們搭起了極為堅實的理論橋樑,足以解釋為什麼這間虛擬房間可能牽動我們的自我認知與隱私行為;但我們必須清楚區分 「有文獻支撐的研究假說」與「已確立的因果定論」。在完成正式的長期追蹤與隨機對照實驗之前,我們不應武斷宣稱「玩一次空房間迷因就會改變一個人的人格或自尊」。
結語:當演算法替你擺好家具,別忘了房間的主人還是你
寫到這裡,讓我們再回頭看一眼那間由 AI 幫你畫出來的房間。
為什麼在 2026 年的今天,全世界有這麼多人願意排隊把一張空白房間的圖丟進對話框,滿懷期待地等著看 AI 會在裡面擺上什麼家具?
或許是因為,在這個資訊爆炸、生活節奏快到讓人來不及喘口氣的時代,我們每個人都活得太過碎片化了。我們在工作群組裡扮演一個角色,在家庭餐桌上扮演一個角色,在社群限時動態裡又扮演另一個角色。我們很少有機會停下來,把過去一年自己走過的痕跡、熬過的夜、迷戀過的小事與放不下的焦慮,全部攤在陽光下好好看上一眼。
而生成式 AI 剛好在這個時候,用一種極度溫柔、極度具象、甚至帶點幽默感的方式,幫我們做了一次「人生碎片的立體策展」。當你看到畫面裡那盞溫暖的檯燈、那疊寫了一半的筆記、還有那隻窩在角落的貓時,你真正被觸動的,其實不是 AI 的算力有多強大,而是你突然在那個虛擬的角落裡,認出了自己過去這段日子認真生活過的證據。
這正是這個迷因最迷人、也最值得被溫柔對待的地方。
只是,當我們帶著微笑欣賞這幅「演算法自我肖像」、準備把它存下來貼給朋友看的時候,請永遠在心底留一塊清醒的角落,記住這篇文章陪你走過的發現:
當我們請 AI「把你所知道的我全部畫出來」時,我們看到的從來就不是完整無缺的自己;我們看到的,是一個由「我曾選擇開口說的話」、「平台記憶機制的篩選」、「繪圖模型的刻板套路」以及「社群觀眾的期待眼光」四方合力捏造出來的數位分身。
那個分身可以很美、很準、很好笑,也很適合拿來當作週末午後重新認識自己的起點。但請別讓那間十幾坪的虛擬樣品屋,定義了你遼闊而複雜的真實人生;更別為了討好那面演算法魔鏡,而在不知不覺中,交出了那些真正只屬於你與摯愛之人的珍貴祕密。
畢竟,AI 充其量只是一個很會幫你擺家具的室友;那間房間的門要為誰打開、窗簾要拉到多低、而真正的你接下來要走向哪裡,決定權,永遠在你自己手裡。
參考文獻與核心檢索資源
- AI Op Zak. (2026, October 17). Empty room trend: what ChatGPT knows about you. https://aiopzak.be/blog/en/chatgpt-empty-room-trend/
- Bem, D. J. (1972). Self-Perception Theory. In L. Berkowitz (Ed.), Advances in Experimental Social Psychology (Vol. 6, pp. 1–62). Academic Press. https://www.researchgate.net/publication/277682193_Self-Perception_Theory
- Carroll, M., Dragan, A., Russell, S., & Hadfield-Menell, D. (2022). Estimating and Penalizing Induced Preference Shifts in Recommender Systems. Proceedings of the 39th International Conference on Machine Learning (ICML), PMLR 162:2686–2708. https://proceedings.mlr.press/v162/carroll22a.html
- Chaney, A. J. B., Stewart, B. M., & Engelhardt, B. E. (2018). How Algorithmic Confounding in Recommendation Systems Increases Homogeneity and Decreases Utility. Proceedings of the 12th ACM Conference on Recommender Systems (RecSys '18), 224–232. https://arxiv.org/abs/1710.11214
- Dcard ChatGPT 板. (2026, October 24). #閒聊 來填滿房間(「用你對我的所有了解填滿這個房間,不要出現任何真人圖片」實例討論串). https://www.dcard.tw/f/chatgpt/p/262345944
- Ellison, N., Heino, R., & Gibbs, J. (2006). Managing Impressions Online: Self-Presentation Processes in the Online Dating Environment. Journal of Computer-Mediated Communication, 11(2), 415–441. https://academic.oup.com/jcmc/article/11/2/415/4617726
- Free Republic. (2026, October 25). What Does AI Know About You? ("Fill this room with everything you know about me, but make it exaggerated"). https://freerepublic.com/focus/f-chat/4400507/posts
- Gonzales, A. L., & Hancock, J. T. (2008). Identity Shift in Computer-Mediated Environments. Media Psychology, 11(2), 167–185. https://socialmedialab.sites.stanford.edu/sites/g/files/sbiybj22976/files/media/file/gonzales-mp-identity-shift.pdf
- Gonzales, A. L., & Hancock, J. T. (2011). Mirror, Mirror on my Facebook Wall: Effects of Exposure to Facebook on Self-Esteem. Cyberpsychology, Behavior, and Social Networking, 14(1-2), 79–83. https://www.researchgate.net/publication/49843871_Mirror_Mirror_on_my_Facebook_Wall_Effects_of_Exposure_to_Facebook_on_Self-Esteem
- Hancock, J. T., Naaman, M., & Levy, K. (2020). AI-Mediated Communication: Definition, Research Agenda, and Ethical Considerations. Journal of Computer-Mediated Communication, 25(1), 89–100. https://academic.oup.com/jcmc/article/25/1/89/5714020
- Lee, A. Y., Mieczkowski, H., Ellison, N. B., & Hancock, J. T. (2022). The Algorithmic Crystal: Conceptualizing the Self through Algorithmic Personalization on TikTok. Proceedings of the ACM on Human-Computer Interaction, 6(CSCW2), Article 543. https://www.researchgate.net/publication/365333170_The_Algorithmic_Crystal_Conceptualizing_the_Self_through_Algorithmic_Personalization_on_TikTok
- Lee, Y., Kim, Y., Lee, K., & Kim, D. (2026). Is This the Real Me?: Investigating Algorithmic Self-Portraits as a Medium for Critical Reflection on Algorithmic Experiences on YouTube. Proceedings of the 2026 ACM Designing Interactive Systems Conference (DIS '26). https://www.semanticscholar.org/paper/07c97ded905cf8ff49782e503c2e7bd2378d3806
- Niu, J., Mazhar, B., Ren, Y., & Ul Haq, I. (2026). Decoding user disclosure intentions in generative AI: Exploring the influence of system attributes on trust and privacy concerns within the extended technology acceptance model. Cyberpsychology: Journal of Psychosocial Research on Cyberspace, 20(2). https://cyberpsychology.eu/article/view/40364
- OpenAI Help Center. (2026). Memory in ChatGPT (Reference chat history & Saved memories). https://help.openai.com/en/articles/8590148-memory-in-chatgpt
- OpenAI Help Center. (2026). Data controls in ChatGPT & Temporary chat in ChatGPT. https://help.openai.com/en/articles/7730893-data-controls-in-chatgpt / https://help.openai.com/en/articles/8914046-temporary-chat-in-chatgpt
- Reddit r/ChatGPT. (2026, August 28). I started asking ChatGPT to create images using everything it already knows about me. Here are 30 prompts to try it yourself. https://www.reddit.com/r/ChatGPT/comments/1w0jh1w/i_started_asking_chatgpt_to_create_images_using/
- 中央研究院(Academia Sinica). (2025/2026). 【專欄】生成式 AI 個資保護的邊界與難題. https://www.sinica.edu.tw/cp/667
- 全國法規資料庫(Laws & Regulations Database of The Republic of China (Taiwan)). 個人資料保護法(Personal Data Protection Act). https://law.moj.gov.tw/LawClass/LawAll.aspx?PCode=I0050021